Setembro de 2026

Um estudo a partir de mais de 50 palestras de três anos de Data Literacy Talks e da comunidade do evento, com mais de 1.100 pessoas
Coordenação do estudo Henrique Portella
Em memória do professor Antônio Maçada
Este Panorama é dedicado ao professor Antônio Carlos Gastaud Maçada, da Escola de Administração da UFRGS, que faleceu em 2026.
Professor e orientador de MBA, mestrado e doutorado no Programa de Pós-Graduação em Administração da UFRGS e pesquisador do CNPq, o professor Maçada construiu uma carreira acadêmica de destaque no campo dos sistemas de informação e da gestão de dados, com trabalhos publicados em periódicos internacionais e uma geração de mestres e doutores formados sob sua orientação. Foi também um dos poucos pesquisadores brasileiros a olhar para o Letramento em Dados com rigor científico. Com seu grupo de pesquisa, investigou a sobrecarga de dados, o tecnoestresse, a fadiga cognitiva e o comportamento de evitação em ambientes ricos em dados, e a relação de tudo isso com o desempenho das pessoas. Essa produção segue viva: em 2026, novos artigos do grupo foram publicados em periódicos internacionais, sinal da escola de pesquisadores que ele formou e que continua o trabalho. É dele o contraponto mais incômodo e mais necessário deste relatório: mais dados não significam, por si sós, melhores decisões.
No Data Literacy Talks Porto Alegre 2024, ele subiu ao palco com a generosidade de quem ensina há décadas. Apresentou a produção do seu grupo, trouxe alunos para a plateia e lembrou, entre uma provocação e outra, que quem trabalha com dados também sente o peso deles. Na mesa-redonda daquela edição, deixou a frase que este estudo usa para descrever o momento atual: já não se sensibiliza para a IA generativa, convive-se com ela. Dois anos depois, os dados da comunidade confirmam que ele estava certo.
A relação do professor com a DataSchool vinha de antes dos eventos. Por muitos anos, ele abriu suas salas de aula na UFRGS para que o tema dos dados chegasse aos alunos de graduação e de pós-graduação, com workshops e conversas que ajudaram a plantar, na academia gaúcha, a inquietação que este estudo registra hoje nas empresas.
As referências à sua pesquisa e às suas falas nos eventos permanecem neste relatório, como registro público de tudo o que ele contribuiu para o tema. Que a saudade se torne lembrança dos bons momentos e de seus ensinamentos.
Sumário executivo
O Letramento em Dados e Inteligência Artificial entrou na agenda das grandes empresas brasileiras como um assunto de tecnologia e está se consolidando como um assunto relacionado a pessoas: depois de investir em plataformas, nuvem e agora IA, as organizações vêm percebendo que o que separa o investimento da decisão bem tomada é a capacidade das pessoas de usar tudo isso. A conclusão vem de três anos de Data Literacy Talks, uma série de encontros que percorrem diferentes cidades do país e já soma mais de 50 palestras e mesas-redondas, somadas às enquetes da comunidade do evento, aplicadas quando o grupo reunia cerca de 500 profissionais; no lançamento deste Panorama, a comunidade já passava de 1.100 pessoas. Passaram pelos palcos empresas de mais de dez setores da economia, de bancos, seguradoras e saúde a mídia, indústria, energia, mobilidade, agronegócio e instituições de apoio a pequenos negócios, entre elas Banco do Brasil, Banco Carrefour, Natura, Localiza&CO, Grupo Bancorbrás, ONS, Thoughtworks e Unimed VTRP. E o diagnóstico se repete de setor em setor: o que impede dados e IA de virarem decisão não é a tecnologia nem o orçamento; é gente que nunca foi preparada para essa linguagem.
Sete achados estruturam esta primeira edição. Primeiro, o reskilling de IA no Brasil está nascendo dentro das áreas de Data & Analytics: na enquete da comunidade, mais da metade das respostas aponta a área de dados como quem puxa o movimento hoje, um retrato da urgência do tema mais do que de qualquer omissão. O modelo que os cases maduros recomendam, dados e RH construindo juntos, ainda é minoria, e é exatamente aí que mora a maior oportunidade mapeada pelo estudo. Segundo, os programas estão migrando de uma lógica de treinamento para uma lógica de cultura, com a percepção crescente de que medir atividade, como horas de curso e dashboards criados, produz apenas uma ilusão de progresso. Terceiro, a segmentação por personas e trilhas se consolidou como padrão dos programas maduros: ninguém mais tenta ensinar a mesma coisa para a costureira da produtora e para o executivo do banco. Quarto, a comunicação deixou de ser apoio e virou disciplina central, com marca própria, identidade visual e profissionais de comunicação migrando para dentro das áreas de dados. Quinto, o patrocínio da liderança segue decisivo, e o desafio menos falado é convencer para cima: nos relatos, o maior obstáculo do líder de dados não é capacitar o time, é letrar os próprios pares e superiores que decidem orçamento. Sexto, o mercado sabe que precisa provar valor e poucos já conseguem: na enquete da comunidade, 57% não medem o resultado formalmente e apenas 3% medem impacto no negócio; entre quem já tem programa rodando, quatro em cada cinco não medem. Sétimo, a IA generativa mudou o ponto de partida: as empresas não precisam mais sensibilizar para o uso, precisam organizar, dar governança e formar critério sobre um uso que já acontece.
Esse sétimo ponto ganhou contorno numérico nesta edição. Nas áreas administrativas, o uso de IA generativa já está liberado em 84% das empresas ouvidas, mas apenas 32% acompanharam a liberação de capacitação ampla; em dois terços delas, a IA circula sem que as pessoas tenham sido preparadas. E o quadro piora conforme o público se afasta do centro analítico: na operação, na linha de produção e no atendimento, a capacitação ampla recua para 26% enquanto o uso restrito a pilotos dobra, tornando-se a resposta mais comum. Diante de um público visto como mais sensível, a reação predominante das empresas é restringir o acesso, e não ampliar o preparo, exatamente o inverso do que fizeram os cases mais bem-sucedidos apresentados no Talks.
O quadro geral é de um mercado que amadureceu rápido na estratégia e na aplicação prática enquanto ainda luta na medição. Quase todos os cases relatam dificuldade em provar retorno; os que conseguem, como os relatos de ganhos crescentes ano a ano em uma grande cooperativa médica, tornam-se referência imediata para os demais. A tese que este Panorama registra para 2026 é que dados e IA deixaram de ser duas conversas: formam uma jornada única de letramento, na qual a urgência da IA abre as portas e a base de dados sustenta o resultado.
O retrato de 2026 em números
Resumo dos sete achados do Panorama 2026, de relance. Verde: avanços. Vermelho: fragilidades. Preto: retratos do momento.
53% — das empresas consultadas indica que a área de dados puxa o reskilling de IA
9% — Apenas 9% das empresas consultadas indica que o reskilling envolve área de dados e RH
49% — é a média de acertos no diagnóstico de Letramento em Dados
4 — competências consolidadas: ler, trabalhar, analisar e comunicar
84% — das empresas consultadas já liberaram a IA generativa no escritório
66% — das empresas consultadas usam a IA sem capacitação ampla das equipes
32% — das empresas consultadas já levaram Letramento em Dados e IA à diretoria e ao C-level
0% — Em nenhuma empresa consultada o Letramento em Dados e IA chegou até a operação
57% — das empresas consultadas não medem o resultado do programa formalmente
3% — Apenas 3% das empresas consultadas medem impacto da Cultura de Dados e IA no negócio
2x — Quando o Letramento em Dados e IA é maduro, o percentual de empresas com ROI significativo sobre os investimentos em IA dobra (DataCamp)
até 50% — de ganho nas quatro competências, medido antes e depois das turmas de Letramento em Dados
10% — Só 1 em 10 colaboradores se sente confortável para ler, trabalhar, analisar e comunicar com dados
1.100+ — pessoas na comunidade de WhatsApp do Data Literacy Talks
50+ — palestras em 9 edições do Data Literacy Talks de 2023 a 2026
Do que estamos falando
Antes dos achados, vale situar o objeto. Cultura de Dados e Inteligência Artificial é o conjunto de hábitos, práticas, valores e costumes de uma organização em torno da informação: como as pessoas decidem, o que consideram evidência suficiente, o que fazem quando o dado contraria a intuição, se procuram o número antes ou depois de já terem decidido. É comportamento coletivo, não tecnologia. E, como todo comportamento coletivo, muda devagar.
O Letramento em Dados e IA é uma das formas de influenciar essa cultura, provavelmente a mais concreta delas. É a capacidade das pessoas de ler, analisar, trabalhar com e se comunicar a partir de dados, agora acrescida da capacidade de usar inteligência artificial com critério, sabendo o que a ferramenta faz bem, onde ela falha e quando não se deve confiar nela. A relação entre os dois conceitos é de meio e fim: não se decreta Cultura de Dados, cultiva-se; e o letramento é uma das principais formas de cultivo. Confundir os dois leva programas a prometerem transformação cultural quando estão entregando treinamento, que é justamente o descompasso descrito no Achado 2 deste relatório.
O que o letramento não é
Não é treinamento de ferramenta. Ensinar onde clicar em uma ferramenta de BI, em uma planilha ou em um copiloto de IA é capacitação técnica, útil e necessária, mas de outra natureza. Quem sabe operar a ferramenta e não sabe formular a pergunta produz relatório, não decisão.
Também não é, no outro extremo, formar todo mundo em ciência de dados. Nenhum dos cases deste estudo pretende transformar a organização inteira em analistas. O que se busca é que cada pessoa alcance o nível de fluência que a sua função exige, o que para muitos significa apenas entender o valor da informação que produzem e saber questionar um número que não faz sentido.
Não é democratizar o acesso. Liberar dashboards, distribuir licenças e abrir o acesso à IA generativa amplia a oferta de informação, não a capacidade de usá-la. Como mostram os dados desta edição, o acesso vem correndo bem à frente do preparo.
Acima de tudo, não é projeto com data de término. É um esforço contínuo, e os cases mais maduros do país o tratam como jornada de anos, não como ciclo orçamentário.
Por que isso importa
Porque o gargalo deixou de ser tecnológico. As organizações brasileiras já investiram em plataforma, em nuvem, em governança e agora em IA, e a barreira que resta para transformar tudo isso em decisão melhor é a distância entre a informação disponível e a capacidade das pessoas de interpretá-la. Investimento em tecnologia que não vira decisão permanece apenas do lado do custo no orçamento.
E porque a IA generativa aumentou a aposta. Uma ferramenta que produz respostas fluentes, confiantes e por vezes erradas exige de quem a usa exatamente o que o letramento desenvolve: capacidade de avaliar evidência, reconhecer contexto e desconfiar na hora certa. Sem isso, a IA acelera decisões ruins com a mesma eficiência com que aceleraria as boas.
O Data Literacy Talks
Este estudo não teria matéria-prima sem o Data Literacy Talks, e vale explicar o que ele é. Não é uma conferência de tecnologia nem um evento de fornecedores. É um encontro, promovido pela DataSchool, de pessoas inquietas, profissionais que decidiram fazer o tema florescer dentro das suas organizações, muitas vezes sem mandato formal para isso, e que precisavam de um lugar para trocar o que estava dando certo e, principalmente, o que não estava.
Ao longo dos três últimos anos, desde setembro de 2023, essas pessoas se reuniram em São Paulo, Porto Alegre, Curitiba, Belo Horizonte e Brasília, além das edições on-line que reúnem participantes de todo o país. Foram nove edições e 58 palestras e mesas-redondas, com quem opera esses programas no dia a dia, ao lado de especialistas internacionais. A generosidade dessas apresentações é o que torna este Panorama possível: são empresas contando publicamente como fizeram e o que deu errado.
58 palestras e mesas-redondas em nove edições do Data Literacy Talks.
Além dos encontros
1.100+ pessoas em uma comunidade que segue trocando.
A primeira edição aconteceu em setembro de 2023, no Dia Mundial da Alfabetização, e este Panorama é lançado em setembro de 2026, quando o movimento completa três anos e inicia o seu quarto ciclo. Da soma desses encontros nasceu também uma comunidade permanente, que chegou ao lançamento deste Panorama com mais de 1.100 pessoas, e que segue crescendo entre uma edição e outra.
Foi a ela que este estudo recorreu para checar, com dados próprios, se o que se ouve nos palcos corresponde ao que acontece nas empresas. Boa parte do que se lê adiante nasceu dessa combinação: a profundidade dos cases apresentados nos palcos e a amplitude do que a comunidade relata nas enquetes, duas fontes que se complementam.
Sobre este estudo
Este é um estudo qualitativo produzido pela DataSchool a partir de duas fontes. A primeira é a análise de conteúdo das transcrições de mais de 50 palestras e mesas-redondas realizadas entre 2023 e 2026 na família de eventos Data Literacy Talks, com edições presenciais em São Paulo, Porto Alegre, Curitiba, Belo Horizonte e Brasília, além de edições on-line, com líderes de programas de dados, cultura e capacitação de grandes empresas brasileiras e especialistas internacionais. A segunda é o conjunto de enquetes realizadas ao longo de agosto de 2026 na comunidade de WhatsApp Data Literacy Talks, que reúne profissionais que participaram das edições do Data Literacy Talks, de diferentes áreas e níveis, com interesse no tema. À época das enquetes, em agosto de 2026, a comunidade contava com 501 membros; no lançamento deste Panorama, em setembro de 2026, já passava de 1.100 pessoas interessadas no tema.
Para ampliar e aprofundar a discussão, esta edição também consultou diretamente relatórios internacionais e artigos científicos selecionados: The State of Data & AI Literacy 2026, da DataCamp, survey com 517 líderes nos Estados Unidos e no Reino Unido sobre competências e treinamento em dados e IA; o AI Index Report 2026, do Stanford HAI, radar global anual de adoção e impactos da IA; e dois artigos de 2026 do grupo de pesquisa do professor Antônio Maçada, da UFRGS, um demonstrando o letramento como amortecedor dos efeitos da sobrecarga de dados sobre o desempenho e outro mapeando os estressores de ambientes intensivos em dados. As referências completas estão no fim do relatório.
Transparência metodológica: este é um retrato qualitativo, não uma amostra estatística do mercado brasileiro; as palestras são relatos das próprias empresas sobre seus programas, e as enquetes ouvem uma comunidade engajada no tema. A metodologia completa e as limitações reconhecidas pelos organizadores estão detalhadas ao final do relatório.
O Panorama em números
Três anos de Data Literacy Talks e a comunidade do evento
3 anos de eventos, de 2023 a 2026
9 edições em 5 cidades, além das on-line
58 palestras e mesas-redondas
240 respostas em 5 enquetes
501 membros à época das enquetes
1.100+ pessoas na comunidade hoje
Achado 1. Quem está puxando o reskilling de IA: a área de dados assumiu a frente
Quem lidera o reskilling de IA
53% das respostas apontam a área de Data & Analytics puxando o reskilling de IA; dados e RH construindo juntos são só 9%
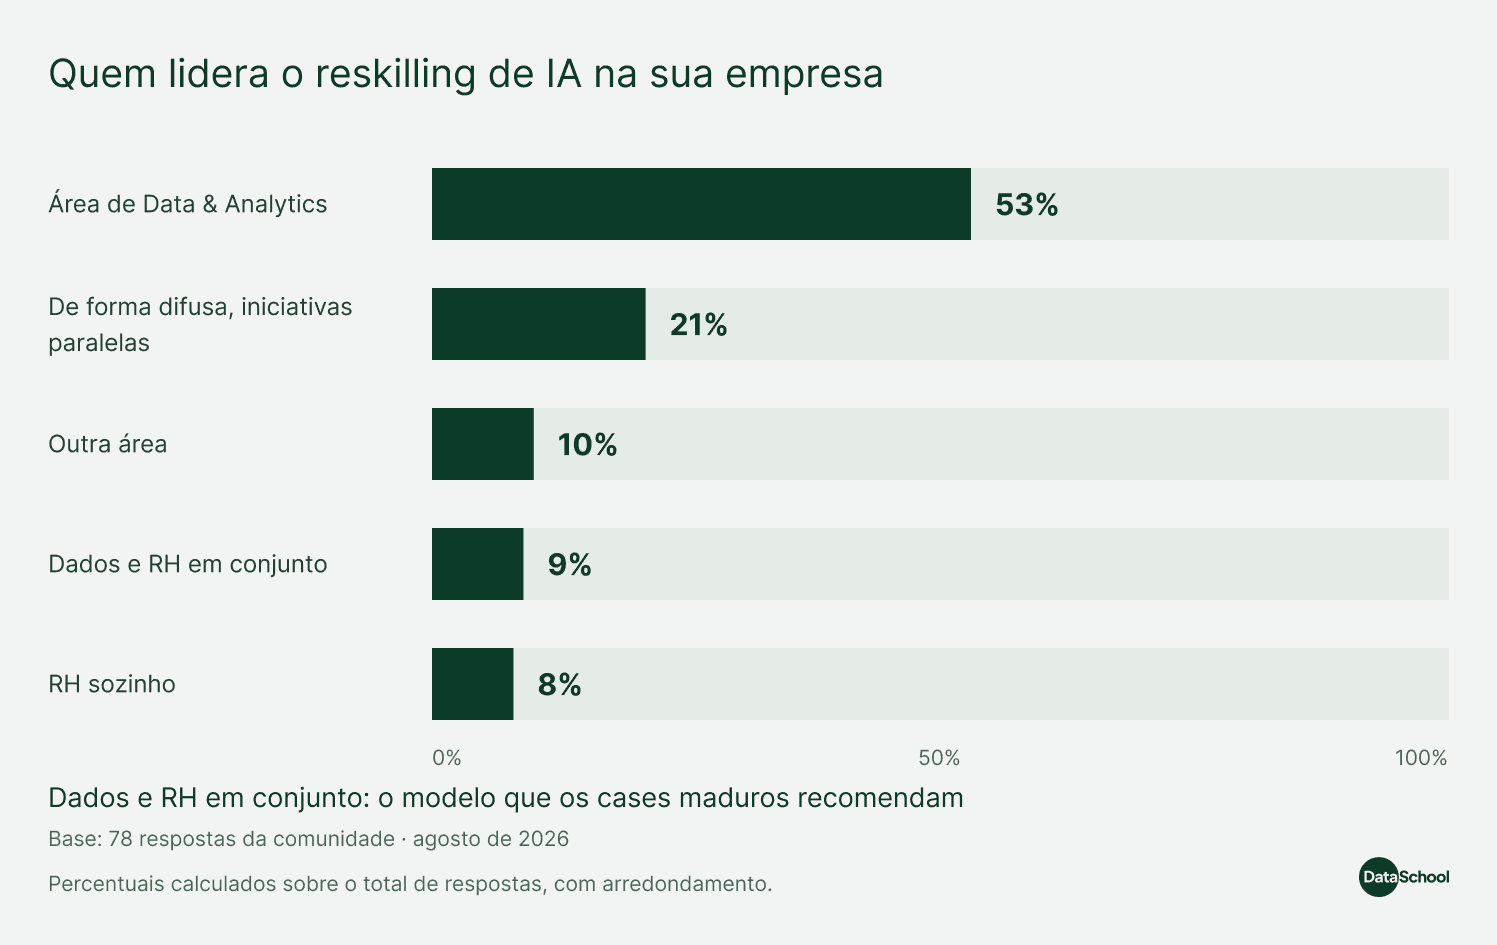
Quem lidera o reskilling de IA: Data & Analytics, 53%; iniciativas paralelas, 21%; outra área, 10%; dados e RH em conjunto, 9%; RH sozinho, 8%. Base: 78 respostas, agosto de 2026.
Trabalhar com IA tem exigido um reskilling rápido das organizações, e a primeira pergunta deste Panorama à comunidade foi direta: quem lidera esse movimento na sua empresa? O resultado mostra que o movimento está nascendo onde a dor chegou primeiro, dentro das áreas de dados, e que a construção conjunta com o RH, recomendada pelos próprios cases maduros, ainda é a próxima fronteira.
Três leituras se destacam. A primeira é a liderança clara da área de Data & Analytics, com mais da metade das respostas. Isso é coerente com o que as transcrições mostram: nos cases apresentados nos eventos, os programas de letramento nascem quase sempre dentro da estrutura de dados, seja em governança, seja em business analytics, e de lá se expandem para a organização. A segunda leitura é o peso do cenário difuso, segunda resposta mais votada: em uma a cada cinco respostas, o reskilling de IA acontece por iniciativas paralelas, sem dono claro. É o retrato de empresas em que a urgência da IA correu mais rápido que a estrutura, um risco de desperdício de esforço e de mensagens contraditórias que os palestrantes do Talks já vinham nomeando. A terceira leitura é a maior oportunidade do conjunto: o modelo que os próprios cases maduros recomendam, dados e RH construindo juntos, ainda é minoria na base, com 9% das respostas. O recorte internacional sugere que o padrão não é local: no survey da DataCamp, os líderes do tema também se concentram nas funções técnicas, com RH e Learning & Development somando cerca de um décimo dos respondentes, e, depois de tempo e orçamento, a barreira mais citada para evoluir as competências da força de trabalho é justamente a falta de um dono claro para o programa.
“A proposta que este Panorama traz é de convite, não de cobrança: quem tem a urgência hoje é a área de dados; quem tem o método de aprendizagem em escala é o RH.”
Henrique Portella
As transcrições das palestras e cases ajudam a entender por que a parceria com o RH importa e por que ela ainda é exceção. Nos programas mais estruturados, o RH ou a universidade corporativa entram como sócios do desenho: na Natura, o programa Data4All opera em parceria formal com o RH, que fornece as diretrizes de treinamento; em uma grande empresa de mídia, o programa de capacitação nasceu de uma parceria entre a área de tecnologia e o RH, que juntos mapearam personas; na Localiza&CO, a jornada de letramento é conduzida pela universidade corporativa em conjunto com o time de dados; em uma instituição de apoio a pequenos negócios, o projeto foi deliberadamente entregue à universidade corporativa, dentro do RH, para ganhar escala e método de educação.
A experiência acumulada sugere que a área de dados dá o conteúdo e a legitimidade técnica, enquanto a área de pessoas dá o método de aprendizagem, os canais e a capilaridade. Quando só uma das duas puxa, o programa tende a ficar tecnicamente correto e pedagogicamente frágil, ou o contrário.
Onde a estrutura já existe, ela costuma vir acompanhada de papéis formais. Um banco público estadual, por exemplo, organiza sua governança em data owner, responsável pelos dados de um domínio, data steward, encarregado de integridade, qualidade e segurança, e data producer ou citizen, quem cria relatórios, painéis e modelos analíticos, com a unidade de inteligência de dados posicionada fora da TI e ligada diretamente à diretoria administrativa. Para 2026, o dado da enquete registra um momento de transição: a área de dados assumiu a frente do reskilling de IA porque foi quem sentiu primeiro a pressão, mas os cases apresentados nos eventos indicam que a maturidade seguinte passa por institucionalizar a parceria com pessoas e educação corporativa, transformando iniciativa de área em programa de empresa.
A Unimed VTRP, cooperativa de saúde com 550 colaboradores e cerca de 800 médicos cooperados, resolve a legitimidade por outro caminho. O Analytics é um processo da cooperativa que atravessa as áreas de Gestão de Informações e TI, respondendo como pares à mesma superintendência. Mas o que sustenta o arranjo não é o organograma: como explica Thaisa Theves, que lidera a área de Gestão de Informações, analisar dados faz parte das atribuições de cargo dos analistas das áreas de negócio, de finanças a áreas assistenciais, e não apenas de quem trabalha com dados. A atribuição foi designada institucionalmente pela cooperativa, não pela área de dados. Onde essa designação existe, a área de dados deixa de precisar convencer as outras a assumir a análise e passa a apoiar quem já tem a responsabilidade formal.
Achado 2. Da miragem da atividade à cultura: o programa que treina muito e muda pouco
O segundo achado atravessa praticamente todas as palestras dos três anos de evento: cresce a consciência de que treinar não é transformar. Kevin Hanegan, autor de referência internacional do tema e palestrante do Talks, deu nome ao fenômeno: “a miragem do data literacy”, a ilusão de progresso de organizações que reportam milhares de treinados, dashboards lançados e licenças distribuídas enquanto as decisões continuam sendo tomadas no instinto. Atividade não é impacto; contar horas de curso não é o mesmo que mudar a forma como as pessoas decidem.
Consultado na checagem desta edição, Hanegan confirmou a validade da tese e a atualizou: a miragem deixou de ser, para ele, apenas um problema de treinamento e passou a ser um problema sistêmico. Organizações podem elevar as habilidades de dados das pessoas e ainda assim ver pouca mudança nas decisões, se as condições em volta permanecerem as mesmas: quem decide, que informação chega a essas pessoas, que comportamentos são reforçados e como a governança molda as escolhas podem se sobrepor ao que se aprendeu em um curso. E a IA, diz ele, torna a lacuna mais importante: à medida que as máquinas ficam melhores em produzir os artefatos da análise, a habilidade mais valiosa passa a ser o julgamento entre eles, o caminho da evidência à interpretação, da interpretação à confiança e da confiança à ação.
Os cases brasileiros confirmam a tese pela via prática, muitas vezes com nomes próprios. Amanda Alves, analista de inteligência de dados de uma instituição de apoio a pequenos negócios, batizou de “era da BI mania” o período pós-digitalização em que tudo virava painel: criava-se dashboard atrás de dashboard até a pergunta incômoda aparecer, será que alguém realmente usa isso? A resposta da instituição foi parar de produzir mais soluções e começar a capacitar as pessoas que as consomem. Priscila Paolinelli, Head of Data & Analytics da Vallourec, deu à mesma frustração a forma de uma camiseta imaginária com a frase que todo líder de dados conhece: esse número não bate. É comum ver reuniões inteiras consumidas em debater a origem de um número em vez de discutir a performance que ele revela. E Sérgio Garcia, Head de Gente e Cultura do Grupo Bancorbrás, lembrou em Brasília o pré-requisito que costuma ser pulado: Cultura de Dados vive dentro da cultura organizacional, e quem não olha primeiro para a cultura da empresa confirma a máxima de Drucker de que a cultura engole a estratégia no café da manhã; no case do Grupo Bancorbrás, o realinhamento da cultura organizacional em 2021 foi o que abriu espaço para a Cultura de Dados entrar em 2022.
A mesma frustração aparece na Unimed VTRP com outra imagem. Thaisa Theves descreve o modelo anterior, centralizado, da sua área como o de quem fritava pastel: a pessoa pedia, a área fritava e entregava. A virada de chave foi deixar de entregar o pedido para tornar as pessoas capazes de questionar os reais problemas da organização e, a partir dos dados, decidir, o que melhorou o próprio resultado, já que o conhecimento aprofundado de negócio estava nas áreas. A cooperativa oferece ainda um contraponto que merece registro: ao trocar de ferramenta de BI, tinha mais de mil painéis criados e decidiu levar apenas cerca de 300 para o novo ambiente. Cortar painéis de propósito é movimento incomum, e a justificativa é a que qualquer programa deveria adotar, de que não adianta criar se aquilo não é usado.
Henrique Portella, coordenador deste estudo, resume nos eventos os sete pontos de atenção que a DataSchool observa nos programas corporativos:
é sobre cultura, não sobre treinamento;
as lideranças precisam estar envolvidas;
o programa precisa ter dados sobre si mesmo;
precisa de orçamento;
comunicação é chave;
cada programa é único porque cada organização é única;
e ninguém precisa começar do zero, porque o mercado já acumulou prática compartilhável.
As referências de mercado citadas nos eventos apontam na mesma direção: o Gartner listava, já em 2018, a dificuldade de aceitar mudança cultural e a baixa alfabetização de dados como as principais causas de insucesso de projetos de dados, à frente de ferramenta e orçamento. César Ripari, diretor da Qlik para a América Latina, apresentou no Talks Brasil 2023, edição dedicada ao Dia Mundial da Alfabetização, os números da própria pesquisa da empresa: nove em cada dez executivos esperam que suas equipes tomem decisões com dados e saibam explicar como chegaram a elas, quase metade dos executivos ainda decide pela intuição e apenas um em cada dez colaboradores se sente confortável para ler, trabalhar, analisar e se comunicar com dados.
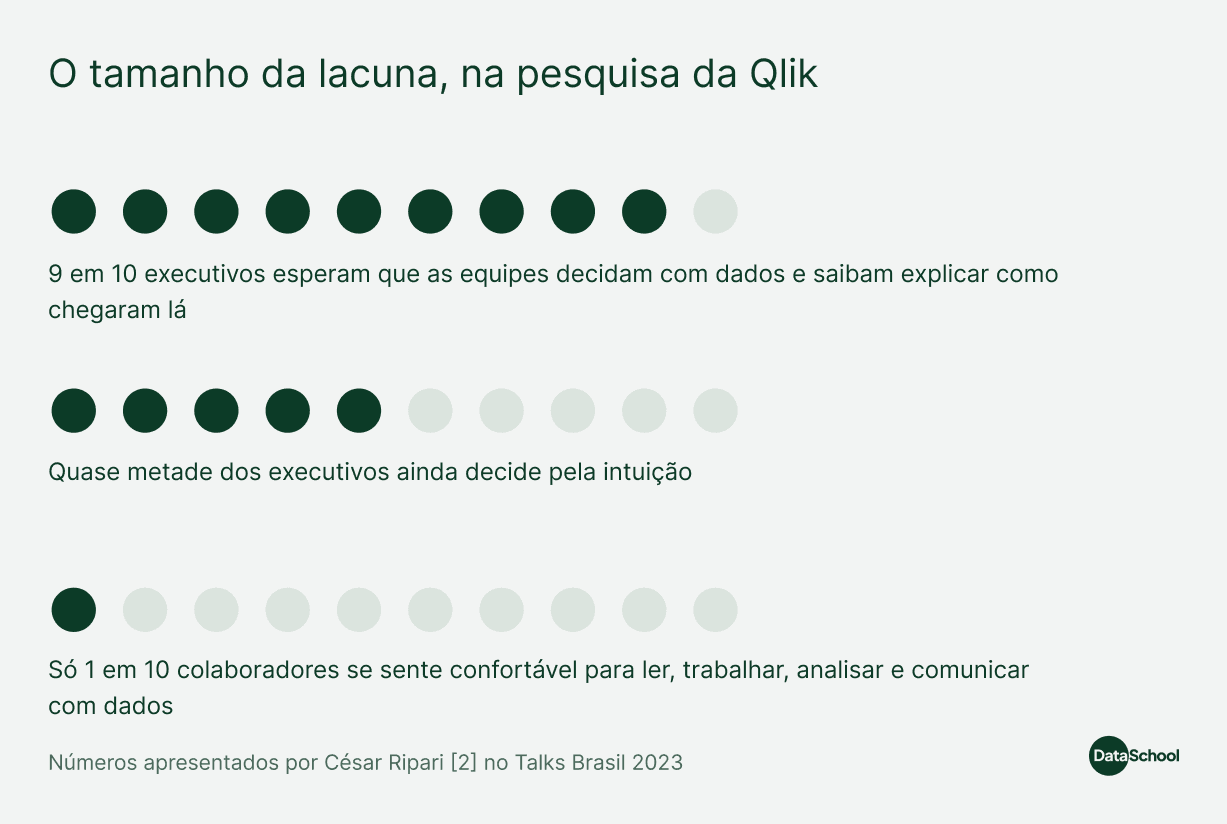
Pesquisa da Qlik apresentada por César Ripari: 9 em 10 executivos esperam decisões com dados; quase metade ainda decide pela intuição; somente 1 em 10 colaboradores se sente confortável para ler, trabalhar, analisar e comunicar com dados.
O letramento tampouco é pauta apenas de empresas em transição analítica. Thiago Boldrini mostrou em Brasília o caso do ONS, o Operador do Sistema Elétrico Nacional: uma organização que nasceu tomando decisões em tempo real baseadas em dados, com maioria de engenheiros no quadro e cerca de 150 sistemas desenvolvidos internamente, quase um sistema para cada sete colaboradores. Mesmo assim, a transformação do setor elétrico, com geração distribuída, baterias e novos modelos de mercado, exige que a operação fique ainda mais orientada a dados, e a alfabetização de dados aparece no plano estratégico de tecnologia do órgão como habilitadora direta da democratização, da qualidade de dados e da IA. A lição: quanto mais data driven a organização já é, mais o letramento vira condição de sobrevivência, não iniciativa de recursos humanos. Henrique Portella sustenta que a consequência prática que os cases extraem é dupla. Primeiro, colocar a cultura antes da ferramenta: ensinar onde clicar não é ensinar a pensar com dados, e programas que começam pelo software assumem, erroneamente, que a cultura virá depois. Segundo, tratar dado como linguagem: fluência vem de praticar em conversas e decisões reais do trabalho de cada um. Henrique Portella costuma resumir a diferença em uma frase que repete nos eventos: “dado é linguagem, e ninguém aprende uma língua decorando o dicionário”. O diagnóstico avaliativo aplicado pela DataSchool, que já soma mais de 10 mil respostas de mais de 230 empresas, reforça o ponto: mais do que a média de acertos, próxima de 49%, o que chama atenção é a dispersão, com grupos que acertam quase tudo e grupos que acertam quase nada dentro da mesma empresa. O problema das organizações não é o nível médio, é a distância entre quem rema e quem está com o remo fora da água.
“Ensinar onde clicar não é ensinar a pensar com dados, e programas que começam pelo software assumem, erroneamente, que a cultura virá depois.”
Henrique Portella
Dois profissionais experientes ajudam a nomear por que a mudança trava. Eduardo Corsi, Cofundador da DataSchool, resume a lógica que deveria orientar todo investimento: se depois de comprar ERP, comprar BI, desenvolver algoritmos e contratar cientistas e engenheiros de dados nada disso virar decisão, é dinheiro jogado fora, e a área permanece apenas do lado do custo no orçamento. Ele descreve ainda um sintoma reconhecível em qualquer empresa, o “painel do fim do mundo”, aquele que traz todos os pontos, no detalhe, e no qual a pessoa gasta minutos filtrando até chegar à informação de que precisava. Produzir mais informação sem preparar quem decide gera desgaste, não decisão.
Luís Rúdi, Gerente de Governança de Dados na Sabesp e cofundador da Tangerines, acrescenta a dimensão institucional do problema e começa desfazendo uma confusão frequente: Cultura de Dados é o conjunto de hábitos, práticas e valores de uma organização em torno do tema, enquanto o letramento é uma das formas de influenciar esses hábitos. São coisas distintas, e tratá-las como sinônimo leva programas a prometer o que não podem entregar. Ele lembra também que a palavra governança carrega no Brasil um estigma associado a burocracia e imobilismo, a ponto de o profissional da área ser, nas suas palavras, quem não era convidado para almoçar com o time. A distinção que ele propõe organiza o debate: governar é garantir que fazemos as coisas certas, olhando para eficácia; gerir é garantir que fazemos certo as coisas, olhando para eficiência. Rúdi cita ainda duas previsões do Gartner que enquadram o risco: a de 2021, de que até 2025 a maioria das organizações que buscassem escalar negócios digitais falharia por não adotar uma abordagem moderna de governança de dados, e a mais recente, de que até 2027 a maior parte das iniciativas de governança fracassará por falta de uma crise, real ou fabricada, que justifique a mudança.
Achado 3. Personas e trilhas viraram o padrão: ninguém mais ensina a mesma coisa para todo mundo
Se em 2023 a segmentação de públicos aparecia como recomendação, em 2026 ela aparece como prática instalada em todos os cases maduros. O princípio é o mesmo em todas as empresas: nem todo mundo precisa virar técnico, mas todo mundo precisa conhecer dados no nível que a sua função exige. Uma grande empresa de mídia mapeou personas com pesquisa interna e gamificação antes de desenhar o programa, e criou desde ações amplas de sensibilização até capacitação profunda para quem desenvolve; o exemplo que a empresa usa para explicar o conceito virou símbolo do movimento: para a costureira e a maquiadora da produtora, letramento é entender o valor da informação com caderninho e caneta na mão, não é aprender machine learning. O Banco Carrefour opera trilhas distintas para negócio, usuários, times técnicos e executivos, com a jornada executiva conduzida pessoalmente pela liderança de dados. O Banco do Brasil combina um pilar de liderança, com curadoria específica para alta gestão, e o AcademIA, iniciativa interna de letramento em Inteligência Artificial, totalmente democratizado, aberto do agente comercial ao vice-presidente. Paulo Ruza, Superintendente de Dados e IA do Banco Carrefour, faz a ressalva que atravessa todo este capítulo: não é receita de bolo, e não adianta pegar o case de uma empresa e tentar repetir igual, porque cada organização tem a sua realidade, ainda que sempre dê para encontrar inspirações. Uma grande seguradora chegou à mesma conclusão por outro caminho: a empresa compreendeu que o desafio técnico já havia sido superado, com cerca de 2 petabytes de dados armazenados no ambiente analítico e mais de 13 mil colaboradores, e a conclusão depois do diagnóstico foi que o próximo passo não era mais técnico, era cultural. A Localiza&CO começou com três perfis no seu programa de Letramento em Dados; testou, mediu e simplificou para dois: colaboradores e lideranças, com avaliação de conhecimento antes e depois de cada trilha. Uma grande operadora de saúde levantou mais de 30 competências com mais de 10 áreas e as traduziu em 15 trilhas. A Natura evoluiu para o passo seguinte, o cuidado com o excesso: trilhas por perfil justamente para não gerar o que a empresa chama de “obesidade mental”, a ideia de que todo mundo precisa treinar tudo.
Dois instrumentos sustentam essa segmentação nos cases. O primeiro é o diagnóstico: medir antes de treinar, para definir público, nível e trilha, e para transformar percepção de lacuna em número que sustenta a conversa de orçamento. É o primeiro mandamento que Jordan Morrow, um dos pioneiros mundiais do campo, repete nas suas participações no Talks: avalie a organização antes de ensinar, porque não se pode criar um programa de tamanho único, e agrupe as pessoas em personas com conteúdo sob medida, lembrando que o objetivo não é converter todo mundo em cientista de dados. José Gava Neto, de outra instituição de apoio a pequenos negócios, resumiu na prática por que o diagnóstico avaliativo importa: quando as pessoas dizem que conhecem dados é uma coisa, quando o diagnóstico é aplicado é outra, porque autoconhecimento é diferente do conhecimento de fato; nessa instituição, o diagnóstico inicial precedeu a capacitação por função e o programa fechará o ciclo com um diagnóstico final para medir o avanço real. Como resumiu Thiago Boldrini, do ONS, no Talks Brasília, o objetivo do diagnóstico não é descobrir se existe lacuna, que todo mundo já sabe que existe, é achar a forma correta de trabalhar com cada público e dar base para o patrocínio. O segundo instrumento é a progressão com marcos claros e vitórias rápidas: como defendeu Gabriel Vernalha, Executivo de Governança de Dados, Analytics, IA e Inovação da Dasa, e diretor do DAMA Brasil, no Talks Brasil 2025: projetos piloto de baixo custo e alto impacto demonstram valor cedo e compram tempo para a jornada longa.
Um refinamento recente vem de um banco público estadual, apresentado no Talks Porto Alegre 2026: em vez de criar papéis de dados do zero, o banco mapeia quem já exerce essas atividades no dia a dia. Nas palavras de Maiara Kauffmann, da área de inteligência de dados de um grande banco público estadual, a empresa não cria curadores de dados; eles já existem, só normalmente não têm método nem habilidades formalizadas, e o programa chega para equipá-los. A área de dados do banco, posicionada fora da TI como área meio entre negócio e tecnologia, opera sob a premissa do self service analytics e se recusa a ser tiradora de pedidos: não entrega relatórios prontos, ensina a fazer a quatro mãos. Até os nomes dos papéis foram traduzidos para o português do dia a dia da instituição, para aproximar as pessoas do tema em vez de afastá-las com jargão.
Uma instituição de apoio a pequenos negócios mostra o que acontece quando esse instrumento é bem conduzido: levou mais de 80% dos seus colaboradores a responder o diagnóstico inicial, da base ao topo da hierarquia. Pedro Pazello, psicólogo e gestor da universidade corporativa da instituição, atribui a marca a duas decisões. A primeira foi vincular o programa ao planejamento estratégico de longo prazo da casa, construído com participação dos próprios colaboradores, de modo que cada um se reconhecesse em algo que ajudou a formular. A segunda foi de natureza psicológica e costuma ser ignorada: foi preciso deixar claro que o diagnóstico não era prova nem avaliação de desempenho, e que ninguém seria exposto a partir dele. Sem esse cuidado, o instrumento que deveria orientar a trilha vira ameaça, e a taxa de resposta despenca. Ele resume ainda o dilema que antecedeu o desenho do programa: ensinar ferramentas ou formar mentalidade orientada a dados? A resposta foi o meio-termo, porque aprender a mexer no BI resolve pouco se a pessoa não passa a enxergar onde o dado está no próprio trabalho, mas o programa também precisa entregar algo concreto.
O que exatamente se ensina: as quatro competências que o Brasil consolidou
Henrique Portella insiste nos eventos que a pergunta correta não é quanto a empresa vai treinar, é o que cada pessoa precisa saber para decidir melhor no lugar onde está. Se a segmentação define para quem, um segundo consenso define o quê, e ele emergiu sem que ninguém o tenha combinado. Uma indústria de bens de consumo abre sua apresentação com a definição de letramento como a capacidade de ler, analisar, trabalhar com e se comunicar a partir de dados. Uma instituição de apoio a pequenos negócios mediu a evolução das suas turmas exatamente nessas quatro habilidades, uma a uma. Uma grande seguradora estruturou seu diagnóstico de maturidade em quatro dimensões equivalentes: interpretar e compreender dados, manipular e processar dados, extrair insights e compartilhar e explicar dados. Uma indústria calçadista centenária, uma instituição de apoio a pequenos negócios e uma seguradora chegaram à mesma decomposição do conceito, sem terem combinado entre si.
A convergência importa porque mostra que a consolidação de vocabulário registrada neste Panorama não parou no termo. O mercado brasileiro não apenas passou a dizer letramento; passou a operar com a mesma estrutura técnica por trás da palavra, o que torna programas comparáveis entre empresas e viabiliza índices setoriais. É também um alerta prático: quem desenha trilha sem cobrir as quatro competências, e comunicar com dados é a mais frequentemente esquecida, entrega um programa incompleto segundo o padrão que o próprio mercado já adotou. O recorte internacional confirma a hierarquia: no survey da DataCamp com 517 líderes de grandes empresas dos Estados Unidos e do Reino Unido, publicado em 2026, os dois maiores gaps apontados são exatamente interpretar informação e transformá-la em boa decisão, e comunicar, contar histórias e influenciar com dados e IA.
As quatro competências que o Brasil consolidou
Mesma decomposição usada por indústria, instituição de apoio a pequenos negócios e seguradora, sem combinação prévia
Ler, interpretar e compreender dados
Trabalhar, manipular e processar dados
Analisar, extrair insights e questionar
Comunicar, explicar e convencer com dados — a mais esquecida nas trilhas
+ usar IA com critério: o que a ferramenta faz bem, onde falha e quando não confiar nela
A mesma decomposição aparece na prática de consultoria. Eduardo Corsi, Cofundador da DataSchool, plota os quatro pilares do letramento diretamente sobre o ciclo decisório do negócio e faz uma leitura útil da divisão de trabalho: ler, analisar e comunicar são competências que interessam sobretudo à área de negócio, enquanto trabalhar com dados é exatamente a interface entre negócio e times técnicos. Ele lembra ainda que, no indivíduo, o caminho do dado até a decisão é percorrido por uma pessoa só, mas nas organizações cada etapa dele é executada por pessoas muito diferentes, com formações distintas, o que torna a competência de comunicar entre elas mais decisiva do que a de operar ferramentas.
Carlos Lozano, que responde por Cultura de Dados na Natura, acrescenta uma condição anterior a qualquer segmentação. A empresa operava como centro de excelência, com as áreas batendo à porta para pedir o dado, o BI ou o dashboard, e concluiu que não teria capacidade de atender na ponta: precisava que o negócio ganhasse autonomia. A saída foi mudar o modelo de operação para “hub and spoke”, com uma célula central responsável por estratégia, arquitetura, governança e capacitação, e o spoke assumindo a propriedade do dado. A frase que sintetiza a virada é: “o dado não é do time de dados, o dado é da Natura, e o indicador pertence à área de negócio, que tem a maior propriedade para dizer como ele deve ser medido”. Lozano insiste também na ordem dos fatores: antes de mexer em cultura e letramento, é preciso ter a base tecnológica, os dados organizados e a governança, que a empresa prefere chamar de “data care” justamente para escapar do olhar burocrático. Sem essa base, o letramento não se sustenta.
Segmentar por prontidão, não apenas por função
Uma grande operadora de saúde acrescenta uma segunda dimensão à segmentação. Além do recorte por área e cargo, a empresa classifica as pessoas por estágio de prontidão em quatro grupos, observadores, exploradores, praticantes e influenciadores, posicionados no cruzamento entre prontidão para mudança e potencial de transformação. A cada estágio corresponde uma intervenção distinta: consciência, educação, treinamento e coaching. A consequência é direta: oferecer treinamento técnico a um observador desperdiça orçamento, e oferecer conteúdo de sensibilização a um influenciador desperdiça talento. O princípio que organiza tudo isso foi resumido pela empresa em uma frase: a Cultura de Dados não se impõe, se constrói.
A mesma empresa lembra que essa construção é longa. Sua linha do tempo começa em 2004, com as primeiras estruturas de data mart, passa por um novo data warehouse na década seguinte, por uma residência em dados em parceria com uma universidade, por trilha on-line e aceleração do data lake, e só então chega ao ciclo atual de IA generativa em escala e Letramento em Dados e IA. O programa de hoje é o quinto capítulo de uma jornada de vinte anos, não um projeto de um ciclo orçamentário.
Começar pelo propósito, não pelo conteúdo
Gabriel Vernalha propõe uma inversão na ordem de montagem dos programas. Recorrendo ao círculo dourado de Simon Sinek, ele defende que a jornada comece pela definição clara do propósito, porque as pessoas se engajam pelo porquê e não pela lista de treinamentos disponíveis. Sem essa definição, o programa vira catálogo. Vernalha organiza os obstáculos seguintes em quatro desafios encadeados: comunicar o propósito, conduzir a mudança cultural, conquistar patrocínio e, só então, evoluir em maturidade. E propõe uma progressão explícita para o público, que sai de explorar dados para ser informado por eles, depois guiado e finalmente orientado a dados, com marcos claros entre cada estágio. É a mesma lógica de estágios que a operadora de saúde citada anteriormente aplica às pessoas, aqui aplicada à organização.
O limite: mais dados nem sempre significam melhores decisões
Há um contraponto que apenas um dos palestrantes trouxe com rigor científico, e ele merece espaço porque contraria o instinto do setor. O professor Antônio Maçada, da UFRGS, a quem este Panorama é dedicado, apresentou no Talks Porto Alegre 2024 a produção do seu grupo de pesquisa sobre os efeitos cognitivos de ambientes ricos em dados, publicada em periódicos internacionais como Information Processing and Management e Aslib Journal of Information Management. Os construtos estudados são incômodos para quem vende volume: sobrecarga de dados percebida, tecnoestresse, fadiga cognitiva, ansiedade e comportamento de evitação, e a relação de tudo isso com o desempenho individual. O número de publicações sobre o tema cresce ano a ano, sinal de um campo que se estrutura.
Essa produção não parou. Em 2026, o grupo publicou novos estudos que dão forma empírica ao contraponto. Em survey com 372 profissionais de dados no Brasil, publicado no periódico Quality & Quantity, Bibiana Cezar, Mauricius Medeiros e o próprio Maçada descrevem um mecanismo de dupla via: a sobrecarga cognitiva e o comportamento de evitação drenam o desempenho nas tarefas, e é o Letramento em Dados que amortece esse efeito negativo, funcionando como recurso de resiliência.
Um segundo estudo, com 40 profissionais entrevistados e publicado no Business Process Management Journal, identifica entre os principais estressores desses ambientes justamente a lacuna de letramento de supervisores e colegas: não saber lidar com dados estressa, e conviver com quem não sabe, também. A recomendação prática dos autores coincide com a agenda deste Panorama: a de investir em letramento em todos os níveis hierárquicos.
A implicação prática dialoga com o que a Natura chama de “obesidade mental”. Ampliar o acesso a dados sem ampliar a capacidade de processá-los pode produzir o efeito oposto ao pretendido, com pessoas evitando a informação em vez de usá-la. O letramento aparece aqui não como incentivo ao consumo de dados, mas como a competência que protege a pessoa da sobrecarga, ensinando o que ignorar tanto quanto o que analisar. É um argumento que os programas brasileiros ainda usam pouco para justificar orçamento e que, com a evidência empírica publicada pelo grupo em 2026, talvez seja hoje o mais defensável de todos.
Achado 4. Comunicação virou disciplina central, com marca, identidade e gente dedicada
Talvez a marca mais brasileira deste Panorama seja o protagonismo da comunicação. Nos cases apresentados, comunicação não é o e-mail que avisa do curso; é uma frente estruturada do programa, com marca própria, identidade visual, canais, campanhas e, cada vez mais, profissionais de comunicação contratados para dentro das áreas de dados. O Banco Carrefour criou a marca GOdata, com identidade visual e linguagem próprias, para competir pela atenção dos colaboradores e quebrar o medo inicial do tema. Natura e Banco Carrefour mantêm especialistas de comunicação e cultura dentro da própria área de dados, e quem ocupa essas cadeiras costuma vir de fora do mundo técnico. Nataly Meschiari, especialista em comunicação e Cultura de Dados, defende a existência do cargo com clareza: é uma função promissora porque permite alavancar a cultura data driven a partir de dentro, liderando canais, eventos e iniciativas de engajamento, num terreno que, nas suas palavras, ainda é obscuro, com as pessoas sem saber por onde começar.
Nancy Vieira, do Banco Carrefour, é publicitária com especialização em comunicação corporativa e uma pós em gestão e análise estratégica de dados, e resume a tese que sustenta o capítulo: dados são sobre pessoas, e olhar para as pessoas apenas no fim do planejamento não muda o jogo. Suas recomendações práticas são diretas:
se as pessoas precisarem decifrar, perdem o interesse, então a linguagem tem que ser adequada e inclusiva;
contextualizar sempre, porque as pessoas colaboram mais com a mudança quando entendem o propósito;
usar os canais que funcionam na organização, não os que a área de dados gostaria de usar;
conhecer antes o tom da comunicação corporativa e interna da empresa;
e tratar branding como construção de identidade, lembrando que marca não é só “carinha bonita”, precisa vir com relevância e consistência.
Ela acrescenta um hábito que poucos programas praticam: ouvir e cocriar com o público, resistindo ao impulso de responder antes de assimilar.
Thainara Barbosa, especialista em governança e Cultura de Dados de uma grande seguradora, descreve a própria função como a de tradutora, alguém que pega conceitos complexos de dados e tecnologia e os transforma em uma história simples que qualquer público entende. A empresa começou a jornada aplicando uma pesquisa de maturidade para medir o conhecimento das pessoas nos quatro pilares, ler, trabalhar, comunicar e analisar, antes de desenhar comunicação e capacitação. Uma grande cooperativa médica atribui à comunicação parte relevante da viabilização do seu Programa Datalab. E, como relata Karen Luz, de Estratégia e Cultura de Dados e IA de uma grande empresa de mídia, a empresa trabalha a leveza como estratégia deliberada, com um festival anual de dados e IA como principal evento de engajamento dos colaboradores, reunindo diferentes formatos e temas para atender aos diversos perfis e níveis de maturidade e incentivando a adoção e o uso, e com jogos de tabuleiro para ensinar governança e privacidade.
Por trás da prática há uma tese de gestão de mudança: cultura é hábito, e hábito se constrói por repetição, pertencimento e reconhecimento, não por obrigação. Daí a recorrência de gamificação, premiações, embaixadores e multiplicadores nos cases: os multiplicadores de uma grande operadora de saúde, as comunidades da Natura e de uma grande empresa de mídia.
E há um movimento de carreira que este Panorama registra como tendência: publicitários, designers e comunicadores migrando para áreas de dados, na função que os próprios protagonistas descrevem como tradutores entre o mundo técnico e o negócio.
Luís Rúdi oferece a esse movimento uma estrutura que vale como método. Ele organiza qualquer ação de Cultura de Dados em quatro Cs:
contexto, entender o cenário e o público antes de agir, porque semente lançada em terreno não fértil não germina, e às vezes a primeira ação necessária é preparar a terra;
canal, mapear as ferramentas e os meios disponíveis para sustentar a ação depois que ela começa;
cadência, porque não se muda hábito com ação isolada, e ninguém alfabetiza uma organização com um único hackathon ou um único dia temático;
e conteúdo, que é onde mensagem e estética precisam se equilibrar, já que conteúdo excelente com apresentação ruim perde impacto, e apresentação bonita sem mensagem não sustenta nada.
A recomendação prática que ele extrai do quarto C converge com o que os cases relatam: conte com profissionais de comunicação, porque programas de dados costumam ficar sob áreas técnicas, e cuidar de estética não é o que essas áreas fazem melhor.
Achado 5. Patrocínio executivo: conquistar apoio da alta gestão ainda é um dos principais desafios para quem está à frente da área de dados e IA
O patrocínio executivo foi tema recorrente em todas as mesas-redondas dos três anos. Os cases mostram os dois caminhos possíveis: em empresas com tradição analítica, como relata uma grande seguradora, o patrocínio veio de forma mais orgânica, com a alta direção já sensível ao tema; na maioria, porém, o programa precisou ser vendido internamente, e as estratégias relatadas formam um repertório prático. Uma indústria de bens de consumo encontrou um patrocinador na alta liderança e acoplou o orçamento do letramento a uma iniciativa de negócio, em vez de defender o tema em abstrato. Uma grande cooperativa médica construiu relações de confiança a partir da qualidade dos estudos entregues, gerando resultado aplicado pelo negócio, o que possibilitou a expansão de escopo da área. Débora Gonçalves, que lidera a área de Business Analytics dessa cooperativa, descreve o ponto de partida em 2020 de forma reconhecível: havia informação do passado, e cada área apresentava os indicadores sob o prisma da sua operação. A área nasceu para transformar dados em inteligência aplicada que gere ação e resultado, e hoje se organiza em três pilares, Inteligência de Mercado e de Negócio, Ciência de Dados e Data & Analytics, contando com 52 colaboradores. A Localiza&CO ajustou a própria trilha de liderança para formar os gestores como evangelizadores e patrocinadores do uso de dados nos seus times.
Uma instituição de apoio a pequenos negócios oferece o contraexemplo mais instrutivo do acervo, e ele vem de alguém de fora do mundo técnico: Pedro Pazello, o psicólogo que comanda a universidade corporativa da instituição, conta que a alta liderança participou das aberturas antes mesmo de o diagnóstico ser aplicado, e que hoje gerência, diretoria e presidência estão entre os maiores consumidores de conteúdo de dados da casa. A tese que ele extrai disso é o que chama de “movimento de espelho”: quando a equipe vê a liderança usando e dominando os conceitos, a adesão deixa de precisar de convencimento. E a conclusão é categórica, do tipo que raramente se ouve em palco: é muito difícil dar certo se a alta liderança não estiver envolvida, participando e puxando o tema.
A enquete realizada na comunidade Data Literacy Talks acrescenta uma nuance a este capítulo: em 32% das 34 respostas, a capacitação em conceitos já chegou à diretoria e ao C-level, a segunda opção mais marcada. Entre empresas engajadas no tema, a liderança está mais coberta do que o discurso corrente sugere. O ponto cego do mercado, pelos dados desta edição, não é o topo da pirâmide, é a base: a operação, que nenhuma resposta apontou como alcançada.
Ainda assim, há uma lacuna específica no topo. Os programas alcançaram os times técnicos e o público de escritório com mais facilidade do que estruturaram jornadas para o C-level: jornadas executivas estruturadas, como a do Banco Carrefour, ainda são exceção, e boa parte dos líderes de dados relata que seu maior desafio não é capacitar o time, é letrar os próprios pares e superiores que decidem orçamento. A pesquisa acadêmica brasileira dá suporte a essa percepção: o estudo do grupo do professor Maçada sobre os estressores de ambientes intensivos em dados, publicado em 2026, identifica a lacuna de letramento de supervisores e colegas como um dos três grandes grupos de estressores relatados pelos próprios profissionais. Graziela Pereira, Regional Head of People Americas, da Thoughtworks, trouxe no Talks Porto Alegre 2026 os números que dão escala ao assunto: no levantamento da PwC com CEOs, 58% das decisões seriam baseadas na própria experiência e apenas 29% efetivamente orientadas por dados, muitas vezes porque os líderes não confiam na origem dos números que recebem; o recorte especial ao final deste relatório detalha o que acontece quando essa lacuna atinge as decisões sobre as próprias pessoas. Letramento de executivos, guiado pela urgência da IA, desponta como a fronteira de 2026 e 2027.
Achado 6. Medição: o mercado sabe que precisa provar valor, mas poucos já conseguem
A medição de impacto é, ao mesmo tempo, o desafio mais citado e a prática menos madura. O diagnóstico é unânime: sem métrica não se justifica o programa, não se renova orçamento e não se sai da miragem da atividade. Priscila Paolinelli dedicou ao tema o fechamento do Talks Brasil 2025: o retorno do investimento tende a se tornar intangível, e o caminho é organizar a medição em camadas, do engajamento e da confiança das pessoas com dados até a qualidade das decisões, a redução de retrabalho e os custos evitados. A prática, porém, ainda se concentra nos indicadores de engajamento, como adesão, conclusão de trilhas, pesquisas antes e depois e evolução em frameworks de maturidade. O retorno financeiro direto segue sendo o elo fraco; nas palavras de Diógenes Justo, Diretor de Dados de uma indústria de bens de consumo: “se alguém tiver uma fórmula matadora para justificar o orçamento, que venha apresentar no próximo evento”.
A enquete da comunidade deu tamanho ao problema nesta edição. Perguntados sobre como suas empresas medem hoje o resultado do programa de Letramento em Dados e IA, 37 participantes responderam: 57% não medem formalmente; 30% ainda não têm programa estruturado; 11% medem engajamento, como adesão, conclusão e satisfação; 5% medem evolução de conhecimento, com avaliação antes e depois; e apenas 3% medem impacto no negócio, em valor financeiro, produtividade ou redução de erro. Entre as empresas que já têm programa rodando, quatro em cada cinco não medem formalmente.
O mercado aprendeu a montar programa de letramento; provar que ele funciona ainda é a exceção.
Justamente por isso, os relatos de quem conseguiu medir viraram os momentos mais anotados dos eventos. Uma grande cooperativa médica relatou a evolução dos ganhos gerados por estudos do seu time de analytics para as áreas de negócio ao longo de quatro anos, com um método explícito de compromisso de acompanhamento de cada oportunidade por 12 meses após a ação realizada a partir do estudo entregue; a confiança construída dessa forma possibilitou a expansão de escopo da área e potencializou a alfabetização e a democratização de dados dentro da cooperativa, por meio do Programa Datalab. O Banco do Brasil acompanha um índice de maturidade analítica que combina capacitação, participação e uso, e relatou a evolução da adoção do Copilot de 42 mil para 60 mil usuários em um semestre; na checagem desta edição, o banco informou estar atualmente com 57 mil usuários. E uma instituição de apoio a pequenos negócios mostrou que dá para medir a evolução da própria habilidade: com o diagnóstico aplicado antes e depois das turmas, relatou ganhos entre 28% e 50% nas quatro competências de letramento, em um programa que já alfabetizou mais de uma centena de colaboradores. Outra instituição de apoio a pequenos negócios mostrou uma terceira via, a avaliação rigorosa de percepção: a totalidade dos participantes classificou o programa como relevante ou muito relevante, três quartos avaliaram a aplicação prática como alta ou muito alta e a eficácia geral ficou próxima de nove.
Como o mercado mede
3% medem o impacto do programa no negócio; entre as empresas com programa rodando, quatro em cada cinco não medem nada formalmente

Medição dos programas: 57% não medem formalmente; 30% não têm programa estruturado; 11% medem engajamento; 5% medem evolução do conhecimento; 3% medem impacto no negócio. Base: 37 respondentes; respostas múltiplas.
Uma grande seguradora acompanha a progressão do alcance ano a ano: foram mais de 250 pessoas capacitadas em 2024, chegando a 2.400 em 2025. Uma grande operadora de saúde, por sua vez, ancora a medição em quatro métricas de negócio pelas quais o time de dados e IA se deixa avaliar: aumentar receita, melhorar a experiência do cliente, reduzir custos e validar hipóteses.
Há ainda uma forma indireta de validação que vários cases usam, o reconhecimento externo: o Programa de Alfabetização em Dados do Banco Carrefour venceu, em 2023, a segunda edição do Prêmio Inovativos na categoria Talentos e Experiência do Colaborador, entre 53 finalistas, e o AcademIA do Banco do Brasil acumulou premiações em pessoas e cultura e em transformação bancária. A lição transversal: medir o programa com a mesma seriedade com que se pede que o negócio meça, começando por métricas de comportamento, como uso efetivo de dados nas decisões e redução de retrabalho, e evoluindo para valor financeiro conforme a maturidade.
O argumento ganhou reforço internacional nesta edição. No survey The State of Data & AI Literacy 2026, conduzido pela YouGov para a DataCamp com 517 líderes de grandes empresas dos Estados Unidos e do Reino Unido, a parcela que relata retorno significativo dos investimentos em IA sobe de 21%, na média geral dos respondentes, para 42% entre as organizações que mantêm um programa maduro de Letramento em Dados para todos os colaboradores, o dobro; e a parcela que não vê retorno positivo cai de 17%, na média geral, para 11% nesse grupo. O número pede a ressalva registrada na nota metodológica, mas aponta na mesma direção dos cases brasileiros: o retorno da IA aparece onde o letramento chegou antes.
A Unimed VTRP acrescenta uma quarta via, a medição institucionalizada da competência. A cooperativa aplicou pesquisas de maturidade analítica ano a ano até 2024, chegando a 4,25 numa escala de 0 a 5, e acompanha a evolução das pessoas pelas avaliações de competências e testes conduzidos pela área de Pessoas & Cultura, não pela área de dados. Ao colocar a medição de conhecimento dentro do instrumento formal de avaliação da empresa, a cooperativa a torna recorrente por construção. O alcance declarado é de 130 colaboradores formados nas trilhas mais densas, equivalente a 23% do quadro. A lição: medir evolução de conhecimento não exige instrumento novo, exige acoplar o tema ao que o RH já mede.
Letramento e retorno da IA
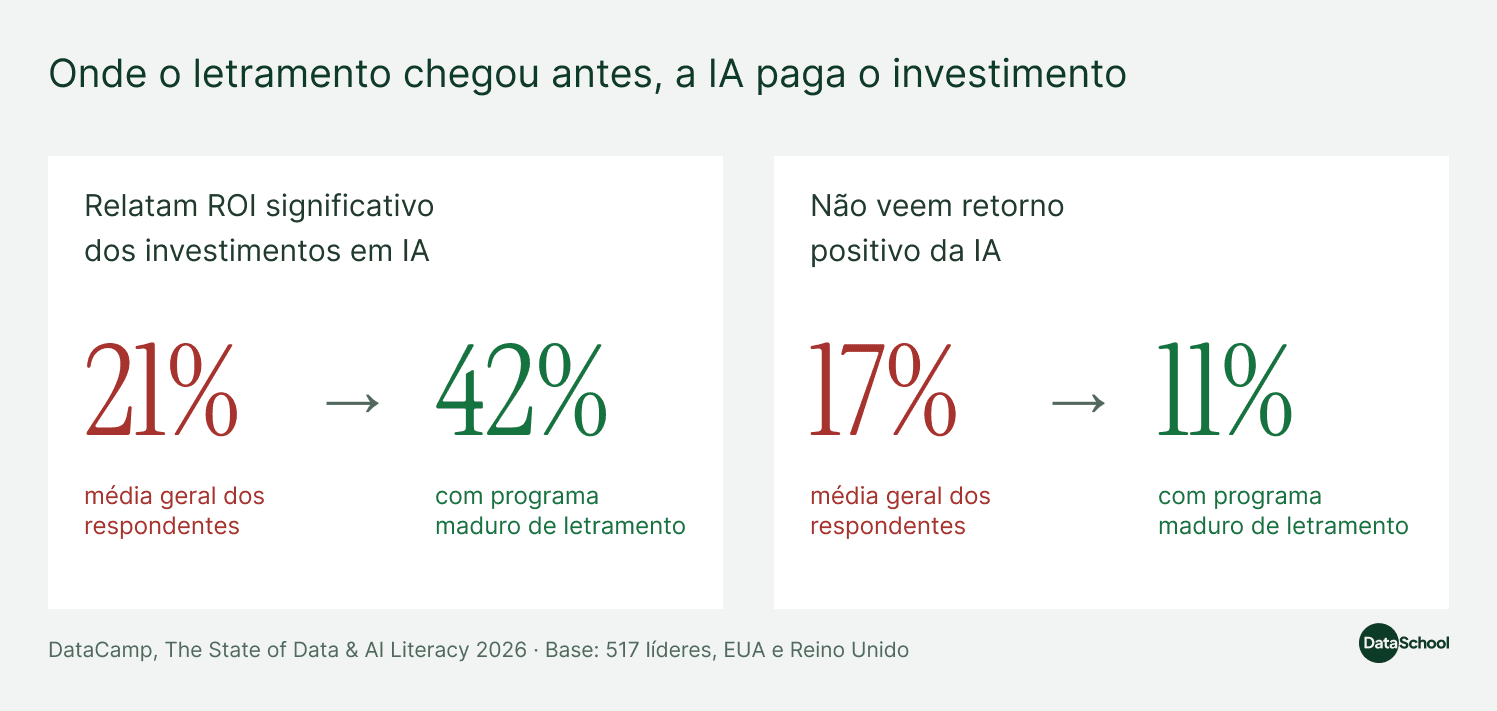
Retorno da IA: 21% dos respondentes relatam ROI significativo, contra 42% entre programas maduros de letramento. A ausência de retorno cai de 17% para 11%. Fonte: DataCamp, 2026; 517 líderes dos EUA e Reino Unido.
Achado 7. IA: a sensibilização acabou, começou a era da organização do uso
Entre 2023 e 2026 a conversa sobre IA nos eventos mudou de natureza. Em 2023, os palestrantes ainda discutiam adoção e medo de substituição; em 2026, o consenso é que o uso já acontece, com ou sem programa, e que o papel das empresas é organizá-lo. Como resumiu o professor Antônio Maçada, da UFRGS, na mesa-redonda de Porto Alegre em 2024, já não se sensibiliza para a IA generativa, convive-se com ela, e as pessoas chegam às empresas trazendo a própria IA, o que exige programas desenhados para receber gente que já vem com conhecimento prévio. A reformulação proposta por Angelika Klidas, referência internacional, dá o tom do momento: a pergunta certa não é se a IA vai substituir as pessoas, é como pessoas e IA se amplificam mutuamente.
Na prática, os cases de 2025 e 2026 mostram três movimentos. Primeiro, governança do uso: uma grande operadora de saúde criou política e guia de uso responsável de IA generativa na esteira da adoção de um copiloto, e o Banco do Brasil, que relata ter sido o primeiro banco da América Latina a publicar diretrizes públicas de IA responsável, incluiu governança como ciclo obrigatório da frente de capacitação AcademIA. Segundo, capilaridade: pílulas de conhecimento, lives práticas por função, mapeamento de heavy users e redes de influenciadores de IA levando o uso à rotina de quem está na ponta, inclusive na agência bancária e no atendimento. Terceiro, a IA saindo do chat e entrando nos processos de gestão: o Grupo Bancorbrás, premiado por seu case de gestão humanizada, aplicou uma IA interna ao processo de calibração das avaliações de desempenho de cerca de mil colaboradores, reduzindo um ciclo de comitês que durava quatro meses para pouco mais de um mês, com 77% das avaliações resolvidas sem comitê e menos espaço para vieses inconscientes; Sérgio Garcia, Head de Gente e Cultura do Grupo Bancorbrás, resume o espírito do case na fórmula da inteligência compartilhada: a IA como o par a mais que organiza os fatos antes da decisão humana. É a mesma tese que Jordan Morrow, um dos pioneiros mundiais do campo, sintetiza na sua fórmula: dados mais IA mais inteligência humana mais inteligência emocional; nas palavras dele, a IA existe para nos empoderar, não para nos substituir. Consultado na checagem desta edição, Morrow acrescentou um ponto que resume a urgência do momento: talvez seja mais importante do que nunca fazer o Letramento em Dados e IA do jeito certo.
Uma grande empresa de mídia, consultada na checagem desta edição, resume o estágio do seu programa: está em constante evolução, acompanhando as tendências do mercado diante da velocidade com que a IA avança; a experimentação passou a integrar o portfólio de conteúdo, e a empresa segue buscando novos formatos e temas alinhados à sua estratégia de IA. Foi o espírito que Marina Fernandes Barreto, que lidera a comunidade de dados e IA da empresa, levou ao palco do Data Literacy Talks Porto Alegre 2025: num mundo guiado por dados e inteligência artificial, a verdadeira transformação começa pelas pessoas, porque a tecnologia sozinha não basta; é a cultura que sustenta, direciona e conecta o propósito à prática.
O uso correu na frente da capacitação
A apresentação do AcademIA BB, realizada no Data Literacy Talks Brasília 2026, abre com uma frase que poderia servir de epígrafe a este capítulo inteiro: IA não transforma organizações, pessoas capacitadas transformam. Os dados da comunidade mostram que o mercado ainda não age como se acreditasse nela.
As enquetes desta edição permitiram medir esse estágio pela primeira vez. A pergunta feita à comunidade foi direta: nas áreas administrativas e de escritório, em que ponto está o uso de IA generativa? O resultado confirma que a sensibilização de fato acabou, e mostra o custo dessa velocidade.
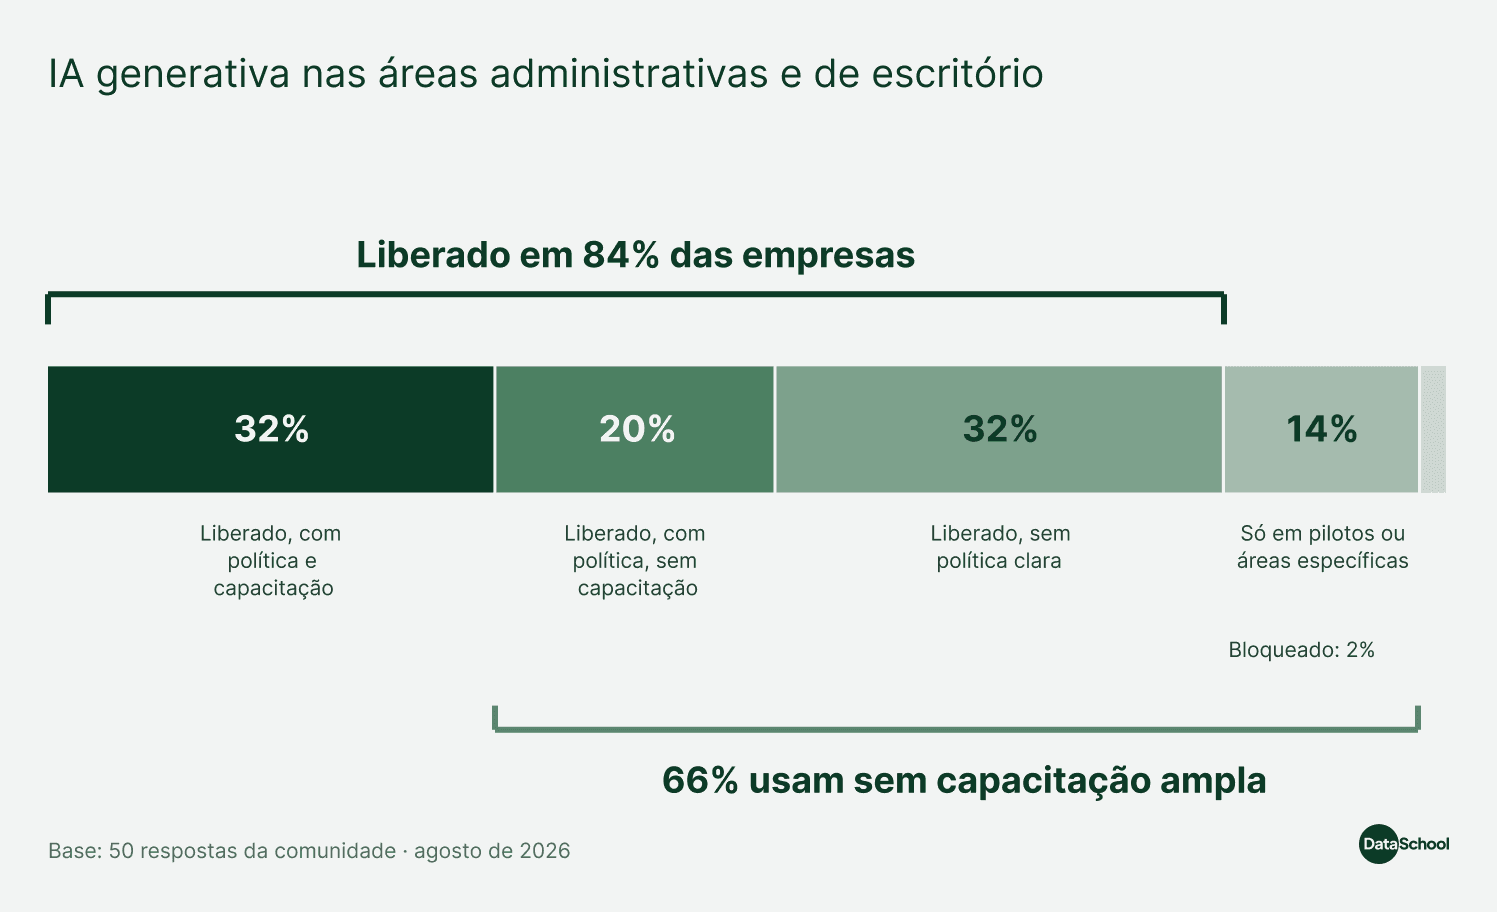
IA no escritório: 32% liberaram com política e capacitação; 20% com política, sem capacitação; 32% sem política clara; 14% usam em pilotos; 2% bloqueiam. Base: 50 respostas, agosto de 2026.
Somando as três primeiras opções, o uso já está liberado em 84% das empresas, número que sepulta a discussão sobre adoção. Mas apenas 32% liberaram acompanhando a decisão de capacitação ampla. Nas outras 66%, descontadas as poucas empresas em que o uso segue bloqueado, a IA generativa circula sem que as pessoas tenham sido preparadas de forma abrangente para usá-la; pilotos e áreas específicas capacitam, mas capacitam poucos. O empate em 32% entre o cenário mais maduro, com política e capacitação, e o mais frágil, liberado sem nenhuma política clara, retrata um mercado partido ao meio nas próprias áreas administrativas.
84% das empresas já liberaram a IA generativa no escritório; só 32% acompanharam a liberação com capacitação ampla
O padrão não é brasileiro, é global. O AI Index Report 2026, da Universidade Stanford, registra que a IA generativa alcançou 53% dos adultos nos Estados Unidos (18 a 64 anos) em três anos, mais rápido que o computador pessoal e que a internet, e que a adoção organizacional chegou a 88%; os ganhos de produtividade medidos ficam entre 14% e 26% em funções como suporte e desenvolvimento de software, com efeitos fracos ou até negativos em tarefas que exigem julgamento, exatamente a competência que o letramento forma. Do lado da capacitação, o survey da DataCamp com líderes americanos e britânicos mostra o mesmo descompasso captado na comunidade: menos da metade das organizações oferece treinamento básico em dados ou IA, apenas 35% mantêm um programa de letramento para todos os colaboradores e 29% treinam somente os papéis técnicos.
O padrão é global
53% dos adultos nos Estados Unidos (18 a 64 anos) usando IA generativa em 3 anos, mais rápido que PC e internet
88% de adoção nas organizações
14 a 26% de ganho de produtividade em tarefas estruturadas; efeito fraco onde o julgamento decide
AI Index Report 2026, Universidade Stanford
O dado dá forma quantitativa à miragem descrita no Achado 2. Liberar acesso é uma decisão de tecnologia, executável em uma semana; formar critério é uma decisão de cultura, que leva meses. Quando a primeira acontece sem a segunda, a empresa passa a exibir indicadores de adoção crescentes enquanto a qualidade das decisões permanece onde estava. É a mesma armadilha que Kevin Hanegan, autor de referência internacional do tema e palestrante do Talks, descreve para dashboards e treinamentos, agora replicada com licenças de IA.
Na ponta, capacita-se menos e restringe-se mais
A segunda pergunta repetiu a mesma escala para outro público, quem está na operação, na linha de produção e no atendimento. A hipótese, sugerida pelos próprios cases do Talks, era de que uma mesma empresa convive com realidades distintas. Ela se confirmou.
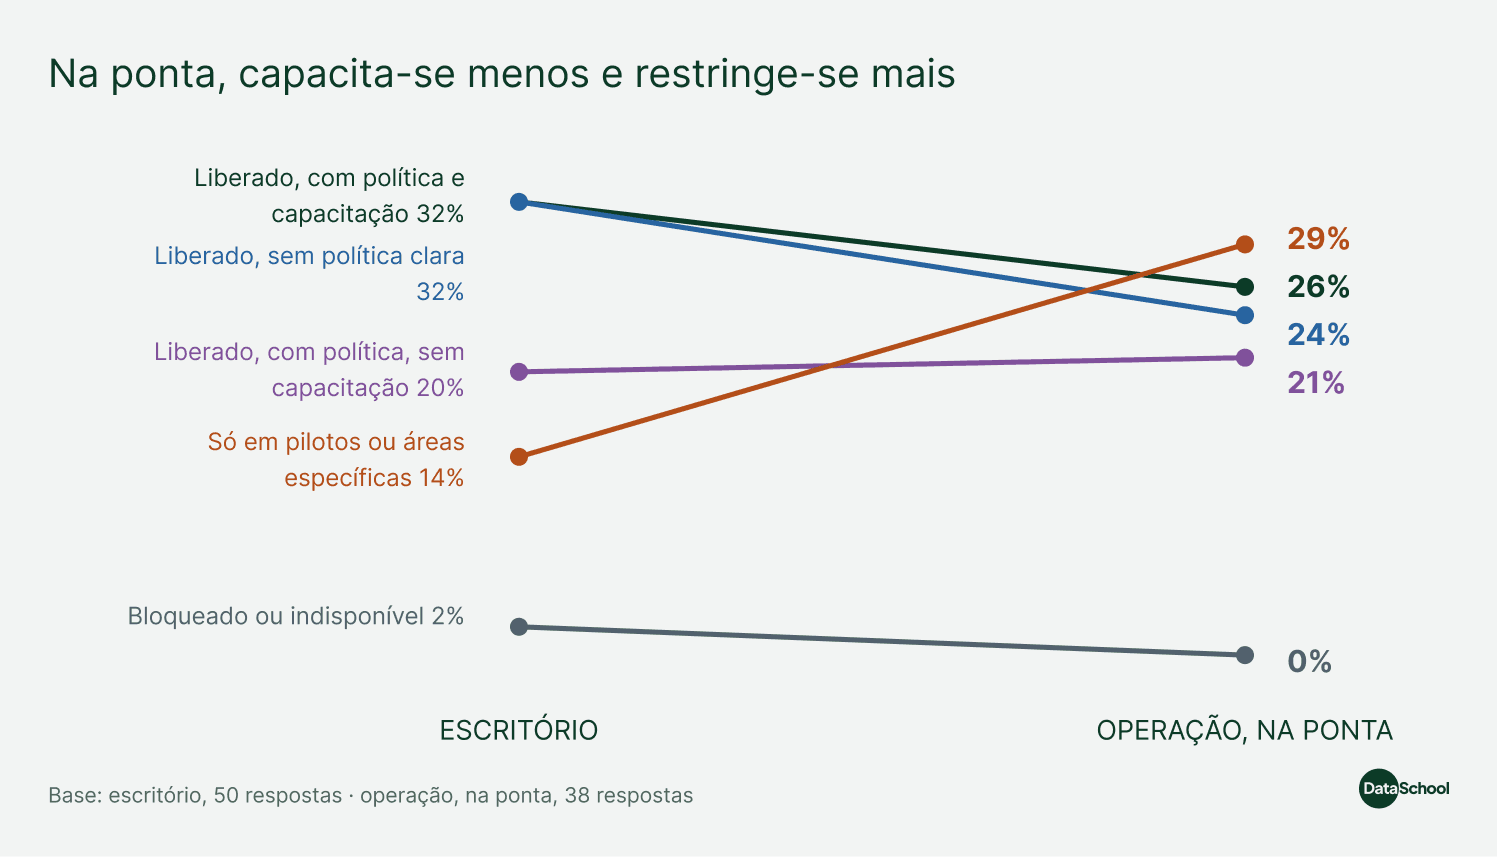
Escritório versus operação: política e capacitação, 32% e 26%; sem política clara, 32% e 24%; política sem capacitação, 20% e 21%; pilotos, 14% e 29%; bloqueio, 2% e 0%. Bases: 50 e 38 respostas.
Dois movimentos se destacam. A capacitação ampla recua de 32% para 26%, e o uso restrito a pilotos ou áreas específicas dobra, de 14% para 29%, tornando-se a resposta mais frequente para a ponta. Diante de um público que a organização enxerga como mais sensível, a reação predominante é restringir o acesso, não ampliar o preparo. Vale a precisão: um piloto normalmente capacita o grupo envolvido, e o que ele não faz é capacitar de forma abrangente.
Aqui a enquete e o acervo de palestras conversam de forma quase incômoda. Os cases que o Talks reuniu em três anos mostram, em ações específicas, o caminho oposto sendo trilhado com sucesso. A empresa de mídia, ao mapear personas na produtora, não excluiu a costureira, a figurinista e a maquiadora por não terem computador; adaptou o formato e levou o letramento com caderno e caneta. O Banco do Brasil, sabendo que o colega em atendimento na agência não consegue parar para uma live, montou pílulas e conteúdos assíncronos em vez de deixá-lo fora do programa. Uma grande cooperativa médica reescreveu o vocabulário das aulas ao perceber que os termos em inglês afastavam quem estava há anos na operação. Em todos esses casos, a dificuldade da ponta foi tratada como problema de desenho pedagógico. Na enquete de 2026, ela aparece sendo tratada como problema de permissão de acesso.
A capacitação sobe antes de descer
A enquete final da série deu número a esse padrão. Perguntada sobre até onde a capacitação em conceitos de dados e IA já chegou, e não o treinamento de ferramenta, a comunidade respondeu assim, em 34 respostas: 47% declararam que ninguém foi capacitado ainda, ou apenas em iniciativas isoladas; 18% chegaram até os times técnicos e de dados; 3% chegaram a técnicos e áreas de negócio; 32% chegaram também à diretoria e ao C-level; e nenhuma resposta apontou a operação e a linha de frente como fronteira alcançada.

Alcance da capacitação: times técnicos e dados, 18%; técnicos e negócio, 3%; operação e linha de frente, 0%; diretoria e C-level, 32%; ninguém ou iniciativas isoladas, 47%. Base: 34 respostas.
O zero é o dado mais significativo da série. A escada foi desenhada como progressão, dos times técnicos à operação e daí à diretoria, e o resultado mostra que ela é pulada: a capacitação sobe para o C-level sem passar pela linha de frente. Lida em conjunto com o par de enquetes sobre IA generativa, a conclusão fecha em pinça: na ponta, o acesso à IA é restrito e a capacitação não chega. Quem está na operação fica de fora duas vezes, do acesso e do preparo. Nenhum case do acervo, e nenhuma resposta da comunidade, relatou até aqui um programa de conceitos que tenha alcançado a linha de frente de forma estruturada; os exemplos de adaptação de formato, como o do caderno e caneta, seguem sendo exceções narradas de palco, não padrão declarado.
0 respostas apontaram a operação e a linha de frente como fronteira alcançada pela capacitação em conceitos
A ressalva justa é que restringir pode ser prudente em contextos de risco regulatório ou clínico, e há setores em que o piloto controlado é a decisão correta. O ponto que o Panorama registra não é a existência do piloto, é a ausência do movimento seguinte: em nenhuma etapa a enquete mostra a capacitação ampla crescendo quando o público fica mais distante do centro analítico da empresa. Se esse padrão persistir, o efeito será uma nova desigualdade interna, com o escritório usando IA e a ponta apenas aguardando liberação, o que reproduz na era da IA a mesma dispersão de letramento que o diagnóstico da DataSchool já identifica em dados.
O quarto ponto é a fundação de dados, e aqui a conversa devolve o Panorama ao seu ponto de partida. César Ripari, Sr. Director, PreSales Latin America da Qlik, foi direto: o valor da IA está diretamente relacionado aos dados que a alimentam, e vale o velho jargão, “entra lixo, sai lixo”; dados corretos, confiáveis e de qualidade são a fundação sobre a qual uma IA ética e útil pode ser construída. Consultado na checagem desta edição, Ripari atualizou o quadro com a pesquisa mais recente da empresa: a tecnologia deixou de ser a maior barreira, e 95% das organizações reportam como maiores causadores de falhas em projetos de IA a qualidade, a disponibilidade e a acessibilidade dos dados (56%), a integração com sistemas existentes (49%) e as lacunas em governança, segurança ou conformidade (47%). Todos os cases reforçam a mesma conclusão: não existe IA confiável sem base de dados tratada e governada. Dados e IA não são duas prateleiras; são uma jornada única de letramento, em que a urgência da IA abre as portas e a base de dados sustenta o resultado.
A Unimed VTRP chega à mesma conclusão por experiência recente: a cooperativa já opera uma IA generativa interna, desenvolvida pela própria TI, e Thaisa Theves, Gerente de Gestão de Informações, é direta ao dizer que não se consegue falar de IA sem a base bem consolidada. Vindo de quem passou cinco anos construindo governança, qualidade e catálogos antes de chegar lá, a afirmação tem outro peso.
Recorte especial. Quando o RH aplica dados e IA a si mesmo
Há uma contradição produtiva escondida entre os achados deste Panorama. O Achado 1 mostrou que a área de pessoas lidera o reskilling de IA em apenas 8% das respostas da comunidade, e que a parceria formal entre dados e RH aparece em outros 9%. O RH, porém, é fundamental para que a identidade da empresa esteja presente nos agentes de IA: por isso mesmo, precisa estar na mesa onde esses agentes são construídos, ao mesmo tempo em que cuida das pessoas, para que a informação se transforme em conhecimento e a organização, em cultura. E dois dos cases mais avançados apresentados no Talks em aplicação de dados e IA à decisão vieram exatamente de dentro do próprio RH, aplicados às suas próprias decisões. Vale a pena olhar para eles separadamente, porque contam uma história diferente da que a estatística sugere.
O ponto de partida é um diagnóstico duro. Graziela Pereira, Head of People Americas da Thoughtworks, abriu sua apresentação no Talks Porto Alegre 2026 com uma pergunta direta ao público, se os líderes de suas empresas decidem com dados ou com sentimentos, e respondeu com números de duas frentes. Nas decisões de negócio, o levantamento da PwC com CEOs indica 58% baseadas em intuição ou experiência e 29% efetivamente orientadas por dados. Nas decisões de pessoas, os números do Gartner são piores: 79% das decisões de gestão de pessoas não usam dados de forma consistente e apenas 12% dos colaboradores confiam que promoções são baseadas em fatos e dados. Recrutamento, sucessão, performance, remuneração, diversidade e investimento em treinamento são decisões de alto impacto tomadas, na maioria das organizações, no sentimento.
Thoughtworks: a área de talentos vira área de dados
A resposta da Thoughtworks foi um processo de cinco anos em três estágios, replicado depois do Brasil para Chile, Equador, Peru, Estados Unidos e Canadá. No mapeamento, a área listou stakeholders e as decisões que cada um toma, mapeou atividades para continuar, transferir, parar ou formalizar, revisou todos os processos de coleta e todas as políticas, e montou uma estratégia de comunicação em três camadas, para o negócio, para a área de talentos e para os colaboradores. Já nessa etapa o time incorporou analista de dados e especialistas em processo, ou seja, a área de pessoas contratou capacidade analítica para dentro.
Na transição, o foco passou a ser equipar os business partners e líderes com acesso direto à ferramenta de dados, e aqui aparece um detalhe de letramento que merece registro: a orientação interna é que, ao responder uma pergunta, não se entregue apenas o número, mas o caminho para encontrá-lo. Responder com um link que direciona ao conteúdo, nas palavras da apresentação, faz parte do letramento. É a diferença entre ser tiradora de pedidos e formar autonomia, exatamente a mesma escolha que o banco público estadual descreve no Achado 3, feita aqui por uma área de pessoas. Na evolução, os stakeholders passaram a ter dados em tempo real, com roteiros padronizados de conversa e fechamentos de trimestre baseados em análise.
Duas frases sintetizam o case e valem para muito além do RH. A primeira, “os dados são filhos dos processos”, explica por que a área começou revisando processos e políticas antes de pensar em ferramenta. A segunda encerra a apresentação: “a base construída ao longo dos anos é hoje o alicerce para o uso de IA”. É a mesma tese que César Ripari defende do lado da tecnologia, aqui comprovada por uma área de pessoas.
Grupo Bancorbrás: IA na calibragem de desempenho, com o humano no circuito
O Grupo Bancorbrás, grupo empresarial dos setores de turismo, consórcio e seguros, foi um passo adiante e colocou IA dentro de um dos processos mais sensíveis da gestão de pessoas, a calibragem das avaliações de desempenho. Sérgio Garcia, Head de Gente e Cultura, deixa explícita a precondição: a empresa mediu sua cultura pelo instrumento do Barrett Institute e obteve 86 pontos, contra média global de 51 e média do segmento de 40, e foi essa solidez que autorizou a ousadia. Cultura primeiro, IA depois, na ordem que o Achado 2 defende.
O diagnóstico do problema é honesto quanto aos limites humanos. O calibrador está sujeito a vieses inconscientes, fadiga decisória, pressão do grupo e inconsistência entre ciclos; o avaliado fica exposto a subjetividade e falta de evidências claras. A pergunta que originou o projeto foi se a IA poderia ser o par a mais que organiza os fatos antes do comitê. No desenho anterior, um comitê multidisciplinar revisava exaustivamente 800 avaliações. No novo, um agente faz a pré-calibragem, a liderança valida cerca de 77% dos casos e o comitê concentra o debate profundo nos 23% de exceção.
O agente não decide, ilumina, e o que ele ilumina é específico: divergências relevantes quando a diferença entre autoavaliação e avaliação da liderança passa de 1,5 ponto, padrões de benevolência ou severidade que distorcem notas, agrupamento de casos por similaridade, mudanças abruptas entre ciclos e métricas desproporcionais. Igualmente importante é o conjunto de salvaguardas declaradas: humano no circuito com decisão e responsabilidade sempre humanas, auditoria contínua com recomendações rastreáveis, transparência sobre o uso dos dados, monitoramento ativo para que o modelo não amplifique vieses históricos e restrição de acesso aos dados de desempenho. É um exemplo raro, no acervo, de governança de IA aplicada de forma explícita a uma decisão sobre pessoas.
Os ganhos relatados são de natureza dupla, operacional e humana: preservação da energia cognitiva dos líderes, que passam a discutir exceções em vez de percorrer uma linha de montagem de avaliações; fim da caixa preta, com regras aplicadas de forma consistente; e feedback mais rico, porque o líder chega à conversa de desenvolvimento com evidências e histórico. A frase de encerramento resume a tese: a IA não substitui o RH, ela substitui a planilha, para que o RH possa voltar a focar nas pessoas.

Grupo Bancorbrás: o ciclo de calibragem de 800 avaliações caiu de quatro meses para pouco mais de um mês. A liderança valida 77% dos casos pré-calibrados por IA; o comitê debate 23% de exceções.
O que os dois cases ensinam
Três lições atravessam ambos. A primeira é a ordem dos fatores: nos dois casos a IA chega depois, apoiada em anos de processo, dado organizado e cultura medida, e não como atalho para pular essas etapas. A segunda é que a área de pessoas, quando aplica dados a si mesma, produz naturalmente o repertório que falta às empresas em que ela apenas apoia o programa dos outros: mapeamento de decisões, governança, comunicação em camadas e salvaguardas éticas.
A terceira é a mais estratégica para o mercado brasileiro. O Achado 1 mostrou que a maturidade seguinte do reskilling de IA passa por institucionalizar a parceria entre dados e pessoas, hoje presente em menos de um décimo das empresas. Estes dois cases sugerem por onde essa parceria pode começar: não pelo RH ajudando a área de dados a treinar a empresa, mas pelo RH usando dados e IA nas suas próprias decisões e, ao fazê-lo, adquirindo a autoridade técnica que a parceria exige.
Síntese: o retrato de 2026 e o que observar em 2027
O Brasil de 2026 tem um movimento de Letramento em Dados e IA que já produziu cases de padrão internacional, uma comunidade ativa em torno do tema e um repertório prático consolidado: segmentar por personas, comunicar com marca e leveza, envolver a liderança, medir comportamento antes de prometer ROI e tratar IA como extensão natural da jornada de dados. Tem também quatro fragilidades nomeadas pelos próprios protagonistas ou reveladas pelos dados da comunidade: a governança do reskilling de IA, hoje concentrada na área de dados ou dispersa em iniciativas paralelas; a formação do C-level, ainda incipiente; a medição de valor, que a maioria reconhece como pendência; e a distância entre liberar e capacitar, que se amplia justamente onde o público está mais distante do centro analítico da empresa.
Para 2027, este Panorama sugere observar, acima de qualquer outro, um indicador de maturidade: quantas empresas estão olhando para todos os seus funcionários e levando a Cultura de Dados e IA a todos, do escritório à linha de frente. É esse movimento que separa o programa que vive em um departamento da cultura que pertence à empresa inteira. Ao redor dele, três sinais complementares: quantas institucionalizam a parceria entre dados e RH na liderança do reskilling; quantas estruturam jornadas executivas de letramento guiadas por IA; e quantas passam a reportar valor financeiro do programa, e não apenas engajamento. O retrato registrado aqui é o de um momento. A próxima edição dirá se o mercado avançou nas fragilidades que este estudo nomeia.
Palavra final
Quando começamos a organizar o primeiro Data Literacy Talks, a pergunta que eu mais ouvia de quem trabalhava com dados no Brasil era se valia a pena insistir. Muita gente estava sozinha dentro da própria empresa, defendendo um tema que ninguém tinha pedido, disputando orçamento com projetos mais fáceis de justificar e ouvindo que aquilo era coisa de área técnica. Três anos depois, com mais de 50 palestras registradas e uma comunidade que já passa de 1.100 pessoas, a resposta é evidente: não só valia a pena como o movimento é maior do que qualquer um de nós imaginava.
Este relatório existe principalmente pela generosidade dos palestrantes que passaram pelos nossos palcos. Eles não vieram apenas mostrar o que deu certo. Contaram o que precisou ser refeito, onde o programa travou e o que fariam diferente. Sem essas pessoas, este estudo seria uma coleção de opiniões. Com elas, virou um retrato.
O mercado brasileiro aprendeu a montar programas, aprendeu a comunicar, aprendeu a segmentar. Ainda precisa evoluir em provar valor e em levar a capacitação para quem está mais longe do centro analítico das organizações. Se há uma inquietação que eu levo desta edição, é essa última. Liberamos ferramentas de IA para o escritório com uma velocidade que não tivemos para preparar as pessoas.
Os cases deste relatório mostram que existe caminho melhor: apostar mais em pessoas.
Esta edição carrega também uma ausência. O professor Antônio Maçada, que abriu as portas da UFRGS ao tema muito antes de ele virar pauta de empresa e que trouxe ao nosso palco o rigor da pesquisa, não estará no lançamento. Parte do que este relatório tem de mais honesto, a lembrança de que mais dados podem significar mais cansaço e não mais decisão, veio dele. Este Panorama é dedicado à sua memória.
Este é um primeiro retrato, com todas as limitações que a nota metodológica assume sem rodeios. Não pretende ser conclusivo; pretende ser útil, e servir de linha de base para que, daqui a um ano, possamos dizer com alguma precisão se avançamos. Críticas metodológicas serão bem-vindas e provavelmente melhorarão a próxima edição mais do que qualquer elogio.
A todos que palestraram, responderam enquetes, mandaram mensagem no privado corrigindo um número ou simplesmente apareceram em uma noite de quinta-feira para falar de dados: obrigado. Um agradecimento especial aos mais de 1.100 membros da Comunidade Data Literacy Talks, que fizeram de um grupo de WhatsApp a maior comunidade de Letramento em Dados e IA do país, e aos sócios e à equipe da DataSchool, que fizeram os eventos acontecer em tantos lugares do Brasil. O tema floresceu no Brasil porque vocês insistiram. Nos vemos na próxima edição.
Henrique Portella, Fundador DataSchool e Coordenador do estudo
Nota metodológica
Esta seção descreve como o estudo foi feito e, principalmente, o que ele não permite concluir. A DataSchool entende que um relatório sobre Letramento em Dados tem obrigação de ser explícito quanto aos limites da própria evidência.
Fontes
Base de palestras: mais de 50 transcrições de palestras e mesas-redondas realizadas entre 2023 e 2026 nas edições presenciais do Data Literacy Talks de São Paulo, Porto Alegre, Curitiba, Belo Horizonte e Brasília, além das edições on-line do Data Literacy Talks Brasil. Além das transcrições, foram analisadas as apresentações em PowerPoint e PDF cedidas pelos palestrantes, que trazem frameworks, linhas do tempo, indicadores e fontes externas nem sempre verbalizados no palco. O material foi tratado por análise de conteúdo temática.
Base de enquetes: enquetes realizadas na comunidade de WhatsApp Data Literacy Talks, formada por profissionais que participaram das edições do evento, reunindo pessoas de diferentes áreas e níveis com interesse no tema, com mais de 1.100 membros no lançamento deste Panorama; à época das enquetes, contava com 501. A enquete sobre liderança do reskilling de IA obteve 78 respostas; a enquete sobre uso de IA generativa nas áreas administrativas, 50 respostas; e a enquete sobre uso na operação, 41 respostas, das quais 38 foram consideradas no cálculo dos percentuais. A enquete sobre o alcance da capacitação em conceitos obteve 34 respostas, e a enquete sobre medição do resultado dos programas, 37 respostas, com múltipla escolha.
Entrevista complementar: um dos cases foi coletado em entrevista dedicada, realizada em agosto de 2026, complementando a base de palestras. Os trechos resultantes passaram pelo mesmo processo de conferência aplicado às demais organizações.
Limitações da base de palestras
Viés de seleção na origem. Quem apresenta um case no Data Literacy Talks é, por definição, quem tem um programa para mostrar. O acervo é, portanto, uma coleção de iniciativas que deram certo o suficiente para virar palestra. Programas abandonados, revertidos ou nunca iniciados não estão representados, e nada neste relatório permite estimar quantos são. Sempre que o texto descreve uma prática como padrão ou consenso, o padrão é entre os cases apresentados, não entre as empresas brasileiras.
Relatos, não auditorias. Todos os números de programas são declarações das próprias empresas sobre si mesmas, apresentadas em contexto institucional favorável, sem verificação independente pela DataSchool. Valores financeiros, percentuais de adoção e resultados de capacitação devem ser lidos com essa ressalva. Onde a atribuição importa, o texto nomeia a fonte.
Fontes externas indiretas. Os levantamentos de Gartner, PwC, Qlik e Fórum Econômico Mundial citados ao longo do relatório chegaram até aqui pelas apresentações dos palestrantes. A DataSchool não consultou os relatórios originais nem verificou se os números permanecem atualizados, e por isso eles são exibidos como foram apresentados nos eventos. Exceção feita aos artigos científicos do grupo de pesquisa do professor Antônio Maçada listados nas referências, que foram consultados diretamente pela equipe do estudo, e a dois relatórios internacionais também consultados diretamente nesta edição: The State of Data & AI Literacy 2026, da DataCamp, survey conduzido pela YouGov com 517 líderes de empresas com mais de 500 funcionários nos Estados Unidos e no Reino Unido, e o AI Index Report 2026, do Stanford Institute for Human-Centered Artificial Intelligence. No caso do relatório da DataCamp, registre-se que a empresa é fornecedora de treinamento em dados e IA e que a amostra se restringe a quatro setores de dois países, o que recomenda ler seus números como referência de direção, não como medida do mercado brasileiro.
Composição desigual do acervo. O número de palestras varia por edição e por ano, e alguns setores estão claramente sobrerrepresentados, com destaque para serviços financeiros e saúde. Setores relevantes da economia brasileira, como agronegócio, educação, comércio e serviços públicos, aparecem pouco ou não aparecem. Empresas de pequeno e médio porte estão praticamente ausentes: quase todos os cases vêm de organizações de grande porte, com estrutura de dados já constituída.
Limitações da base de enquetes
Amostra autosselecionada. A comunidade é formada por quem passou pelos eventos e escolheu permanecer, o que a torna um público engajado com o tema, não uma amostra probabilística do mercado. Não há controle de quem responde, e a mesma pessoa poderia responder a algumas enquetes e não a outras. Os percentuais descrevem quem respondeu àquela pergunta específica, e nada além disso.
Bases pequenas e variáveis. As enquetes tiveram entre 34 e 78 respostas. Diferenças de poucos pontos percentuais entre opções não são significativas e não devem ser lidas como tendência. As bases são reportadas separadamente em cada gráfico justamente para que o leitor pondere cada resultado pelo seu tamanho.
Exclusões no cálculo. Na enquete sobre a operação, as respostas de quem declarou não saber informar ou não possuir esse público foram excluídas do cálculo dos percentuais, por não descreverem um estágio de uso. Essa decisão eleva os percentuais das demais opções em relação ao total de respondentes, e o número bruto está informado acima para quem quiser refazer a conta.
Ausência de rastreamento individual. As enquetes são independentes e não permitem saber como um mesmo participante respondeu a duas perguntas diferentes. A comparação entre escritório e operação compara distribuições, não trajetórias individuais, e por isso o relatório não utiliza representações de fluxo entre as duas colunas. Também não é possível cruzar respostas com porte de empresa, setor ou área de atuação do respondente.
Conhecimento parcial do respondente. Parte dos participantes não tem visão integral da organização em que atua, o que ficou evidente nas respostas de quem declarou não saber informar sobre o uso de IA na operação. Respostas sobre políticas corporativas refletem a percepção de quem respondeu, não necessariamente a política formal da empresa.
Consulta anterior sobre medição. O tema da medição de impacto já havia sido objeto de uma consulta à comunidade em julho de 2026, com formulação e opções diferentes das utilizadas nesta edição. Os dois resultados não são comparáveis entre si, e este relatório utiliza apenas a enquete de agosto de 2026.
Limitações de independência
A DataSchool não é observadora neutra do campo que analisa. É autora deste estudo, organizadora dos eventos de onde vem todo o acervo de palestras, administradora da comunidade em que as enquetes foram aplicadas e fornecedora de serviços de Letramento em Dados, incluindo para parte das organizações citadas. O estudo não passou por revisão editorial independente nem por comitê científico externo. O leitor deve considerar esses vínculos ao avaliar as conclusões, especialmente aquelas que apontam necessidade de capacitação.
A seleção dos temas, dos achados e dos trechos citados foi feita pela equipe do estudo, e envolve julgamento editorial. Outra leitura do mesmo acervo poderia organizar o material de outra forma e chegar a ênfases diferentes.
Uso de inteligência artificial na produção do estudo
Este Panorama foi produzido com apoio de inteligência artificial, e registrá-lo é coerente com o que ele defende. A transcrição dos vídeos das palestras e mesas-redondas foi feita com o Gemini, do Google. A análise das falas e a sugestão de textos e insights contaram com o Claude, da Anthropic, no modelo Fable 5. A edição do texto foi apoiada pelo GPT 6 Astra, da OpenAI. Em todas as etapas, porém, a decisão sobre o que entra e o que não entra neste relatório foi da coordenação do estudo: os achados foram conferidos contra as transcrições, as citações passaram pelo processo de cortesia e checagem descrito nesta nota, e a DataSchool não abriu mão de discernir o que deveria ou não constar destas páginas. A IA acelerou o trabalho; o critério permaneceu humano, que é exatamente a tese deste relatório.
Processo de validação e terminologia
Os trechos que atribuem fatos, números ou processos internos a empresas específicas foram enviados às pessoas que os apresentaram, para conferência antes da publicação. Onde não houve retorno até a data-limite, ou onde houve pedido nesse sentido, a informação foi publicada sem identificação da organização. Falas conceituais e de opinião foram comunicadas aos autores como cortesia, mantendo-se o crédito quando não houve manifestação em contrário. Isso significa que parte das descrições anônimas neste relatório corresponde a empresas identificáveis por quem acompanha o setor, e que a ausência de nome nem sempre indica ressalva da empresa quanto ao conteúdo.
Terminologia: este relatório usa Letramento em Dados e IA como termo central, também chamado de alfabetização de dados ou data literacy.
O Panorama do Letramento em Dados e IA no Brasil é uma publicação anual da DataSchool. Esta é a primeira edição, com lançamento no Data Literacy Talks Summit de 17 de setembro de 2026. Críticas metodológicas e sugestões para a próxima edição são bem-vindas e podem ser encaminhadas à DataSchool.
Contatos DataSchool
Site: www.dataschool.com.br WhatsApp: +55 51 9 9723 5634 Email: secretaria@dataschool.com.br
Referências
Referências: palestras que compõem este estudo
Este Panorama foi construído a partir das palestras e mesas-redondas relacionadas abaixo, apresentadas nas edições da família de eventos Data Literacy Talks entre 2023 e 2026. Estão listados o título da apresentação e a organização representada, agrupados por edição. Para as organizações que não concluíram a autorização de citação nominal, a listagem usa uma referência genérica do setor. As gravações e materiais integram o acervo da DataSchool.
Data Literacy Talks Brasil 2023 (Dados e o Dia Mundial da Alfabetização)
Alfabetização de Dados: Apoiando Decisões Estratégicas | Instituição de apoio a pequenos negócios
As 7 capacidades que irão viabilizar os seus projetos de IA | Iprocess
Building a Solid House: An Organizational Data and AI Literacy Fundament | Palestra internacional
Case de Alfabetização de Dados | Instituição de apoio a pequenos negócios
Citizen Data Scientist: Conectando Executivos a Insights com IA | Yara Internacional
Data and AI Literacy: DOs and DON’Ts | Palestra internacional
Data Driven Canvas: Uma ferramenta de transformação cultural e alfabetização de dados | iMaps
Desafios do Data Literacy Corporativo | DataSchool
Desmistificando a Governança de Dados | Palestra independente
Sua empresa fala a língua dos Dados e Inteligência Artificial? | Qlik
Understanding Data Literacy | Palestra internacional
A jornada da Cultura de Dados: ouvindo o cliente e construindo uma cultura sólida de dados | Banco Carrefour
Data Literacy Talks Porto Alegre 2024
A jornada da Cultura de Dados | Banco Carrefour
Data Lab e a Alfabetização em Dados | Unimed Porto Alegre
Data Literacy e Aspectos Comportamentais | UFRGS
Desafios do Data Literacy Corporativo | DataSchool
Desafios e Aprendizados com Letramento de Dados | Indústria de bens de consumo
Mesa-redonda | Indústria de bens de consumo, Unimed Porto Alegre, UFRGS e Banco Carrefour
Data Literacy Talks Curitiba 2025
Case de Alfabetização de Dados | Instituição de apoio a pequenos negócios
Case de Alfabetização de Dados | Natura
Desafios da Alfabetização de Dados Corporativa | DataSchool
Data Literacy Talks Belo Horizonte 2025
Case: a jornada da Cultura de Dados | Banco Carrefour
Como impulsionar uma cultura Data Driven | Grande operadora de saúde
Desafios da Alfabetização de Dados Corporativa | DataSchool
Jornada da F.U.S.C.A. | Localiza&CO
O fim do achismo: como decidir usando Dados e IA | Vallourec
Mesa-redonda | Vallourec, Banco Carrefour, Grande operadora de saúde e Localiza&CO
Data Literacy Talks Brasil 2025
6 Desafios dos Programas de Alfabetização de Dados e IA | Vallourec
A Estrutura da Cultura de Dados | Palestra independente
Case de Cultura de Dados | Sicredi
Case de Cultura de Dados | Grande operadora de saúde
Case de Cultura de Dados | Grande seguradora
Comunicação Estratégica para o Sucesso da Cultura de Dados | Banco Carrefour
Comunicação para Viabilizar o DataLab | Unimed Porto Alegre
Dados e Pessoas: A Chave da Transformação Cultural | Grande seguradora
Demystifying the World of Data and AI | Palestra internacional
Globo e a Cultura de Dados | Globo
Jornada da F.U.S.C.A. | Localiza&CO
Os Desafios da Alfabetização de Dados | Palestra independente
People and Data Literacy in the Age of AI | Palestra internacional
Programa Data4All | Natura
Unconventional Paths to Data Literacy | Palestra internacional
Data Literacy Talks Porto Alegre 2025
Case de Cultura de Dados | Grande seguradora
De Dados à IA: Uma Jornada Muito Além de Tecnologia | Globo
Programa Datalab | Unimed Porto Alegre
Mesa-redonda | Grande seguradora, Unimed Porto Alegre e Globo
Data Literacy Talks Summit 2025
Building a True Data Culture | Palestra internacional
Empowerment Through Data and AI Decision Making | Palestra internacional
The Power of Collaboration and a Common Language in Data and Analytics | Palestra internacional
Data Literacy Talks Brasília 2026
AcademIA BB | Banco do Brasil
Gestão Humanizada na Era Digital com IA | Grupo Bancorbrás
ONSTEC | ONS
Mesa-redonda | Grupo Bancorbrás, ONS e Banco do Brasil
Data Literacy Talks Porto Alegre 2026
AI adoption and Human amplification | Palestra internacional
Cultura de Dados | Thoughtworks
Estratégia e Cultura | Natura
Nossa Jornada em Cultura de Dados | Banco público estadual
Mesa-redonda | Banco público estadual, Thoughtworks e Natura
As referências externas citadas ao longo do relatório, incluindo levantamentos do Gartner, da PwC, da Qlik e do Fórum Econômico Mundial, foram apresentadas pelos palestrantes em suas exposições e são reproduzidas aqui conforme apresentadas.
Artigos científicos consultados
Cezar, B. G. S.; Medeiros, M. M.; Maçada, A. C. G. The bright side of big data: the role of data literacy in mitigating negative effects on task performance. Quality & Quantity, 2026.
Cezar, B. G. S.; Maçada, A. C. G.; Medeiros, M. M. The dark side of big data organizational environments: beyond data stressors, a transactional theory of stress and coping perspective. Business Process Management Journal, 2026.
Relatórios de mercado consultados
DataCamp. The State of Data & AI Literacy 2026. 4ª edição. Survey conduzido pela YouGov com 517 líderes nos Estados Unidos e no Reino Unido, dezembro de 2025 a fevereiro de 2026.
Stanford Institute for Human-Centered Artificial Intelligence (HAI). Artificial Intelligence Index Report 2026. 9ª edição. Stanford University, 2026.
Entrevista complementar
Data For All: o programa de alfabetização de dados | Unimed VTRP | Agosto de 2026
V1-17092026